Más razonamiento no garantiza una respuesta mejor. Antes de elegir medium o extra-high, comprueba si tu servidor reconoce ese ajuste, qué límite de generación utiliza y dónde devuelve la respuesta visible. Un texto vacío puede ser un problema de presupuesto o de lectura de la API, no una prueba de que el modelo haya fallado en razonar.
En corto: comprueba soporte, límites y campos de salida antes de culpar al modelo.
Tres controles que no debes confundir
El esfuerzo de razonamiento expresa una preferencia de trabajo en los modelos que lo admiten. El presupuesto de razonamiento limita cuánto puede dedicarse a esa fase cuando el motor implementa ese control. El límite de generación establece un techo de salida según el contrato de la API. No son tres nombres intercambiables.
Los valores low, medium o xhigh no forman un estándar universal. Una interfaz puede mostrarlos aunque el servidor los traduzca, ignore o rechace. El punto de partida es la documentación de la versión que realmente ejecutas, no una receta tomada de otro proveedor.
| Control | Pregunta útil | Error frecuente |
|---|---|---|
| Esfuerzo | ¿El modelo reconoce este valor? | Suponer que medium equivale a una cifra fija |
| Presupuesto | ¿Hay límite explícito de pensamiento? | Confundirlo con el límite de contexto |
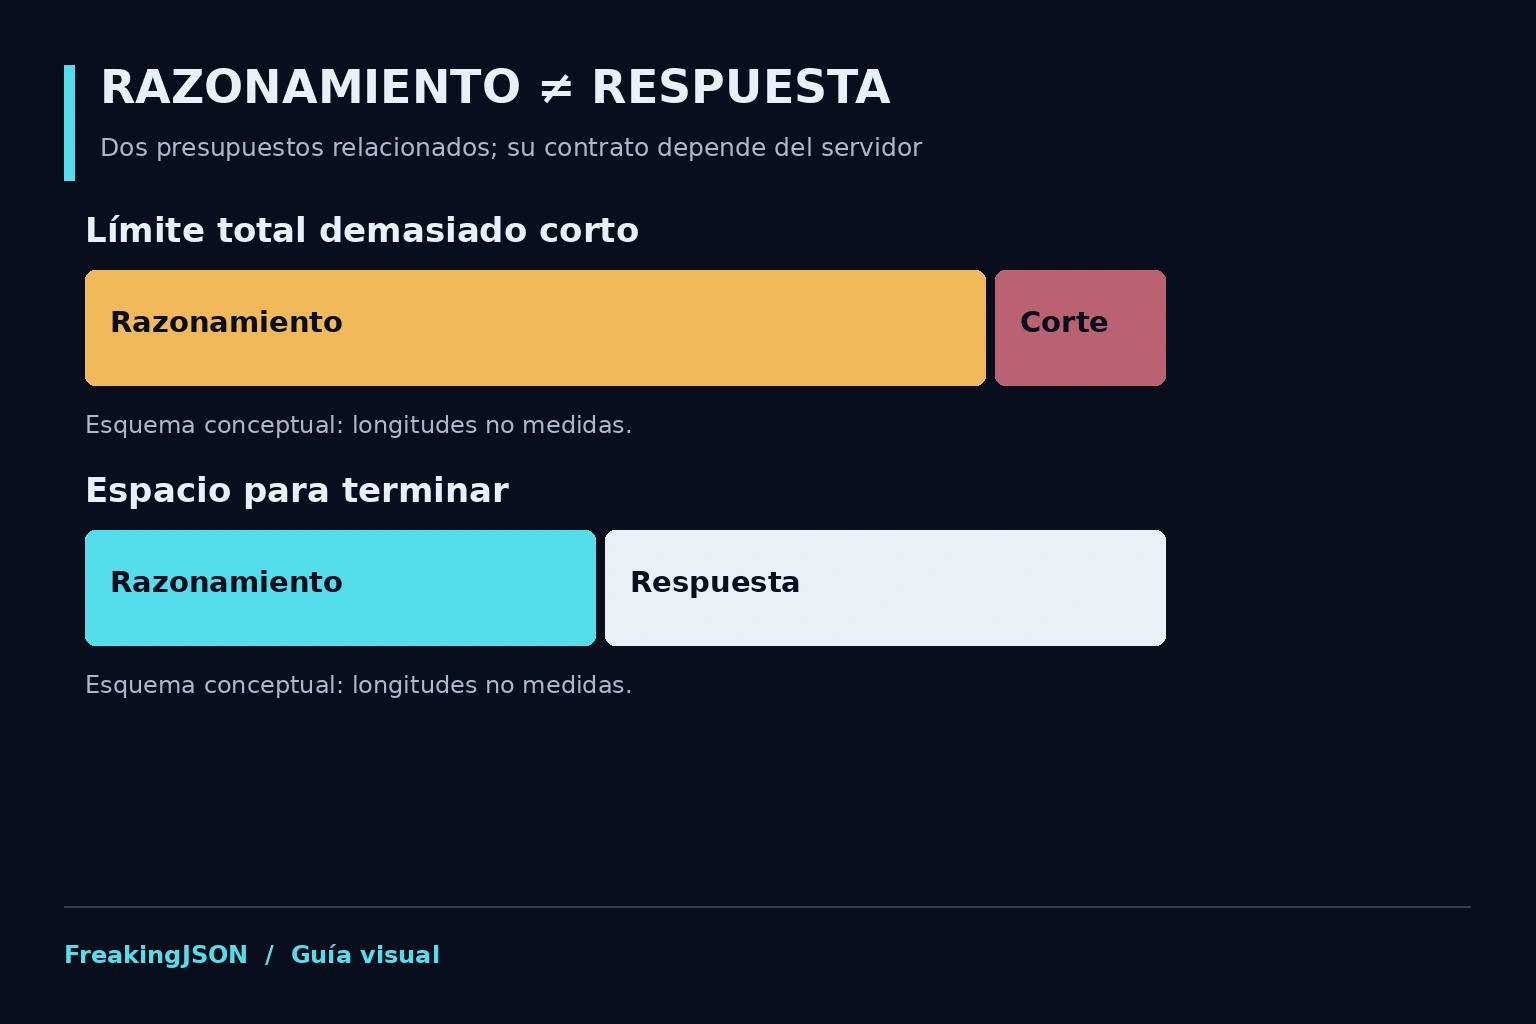
| Generación | ¿Qué cuenta contra el máximo? | Dejar espacio insuficiente para terminar |
Una respuesta vacía tiene varias explicaciones
Empieza por el motivo de finalización. finish_reason=length indica que se alcanzó un límite, pero no identifica por sí solo qué ajuste era incorrecto. Después examina los campos del objeto devuelto. En llama.cpp, --reasoning-format puede dejar el pensamiento en message.content o separarlo en message.reasoning_content.
Si el cliente solo lee un campo, puede mostrar una pantalla vacía mientras otro contiene texto. Eso tampoco significa que haya una respuesta final útil: hay que distinguir la fase de razonamiento de la conclusión. Comprueba asimismo errores de plantilla, secuencias de parada y cortes del cliente por tiempo de espera.
Qué sí documenta llama.cpp
«Presupuesto de tokens para pensamiento: −1 sin restricción, 0 para finalizar inmediatamente, N mayor que 0 para un presupuesto de tokens». — ayuda de
--reasoning-budgeten llama.cpp; traducción propia.
Esta descripción corresponde al servidor consultado en septiembre de 2026. No certifica el comportamiento de forks antiguos ni de otras interfaces. Revisa primero llama-server --help en tu instalación; si la opción no existe, no añadas el flag a ciegas.
La tarjeta de Qwen3-30B-A3B documenta, para ese modelo, el cambio entre modo de pensamiento y modo sin pensamiento mediante enable_thinking. Es otro control diferente. No lo generalices a todas las generaciones Qwen ni lo confundas con niveles de esfuerzo de servicios externos.
Cómo comparar sin inventar una causa
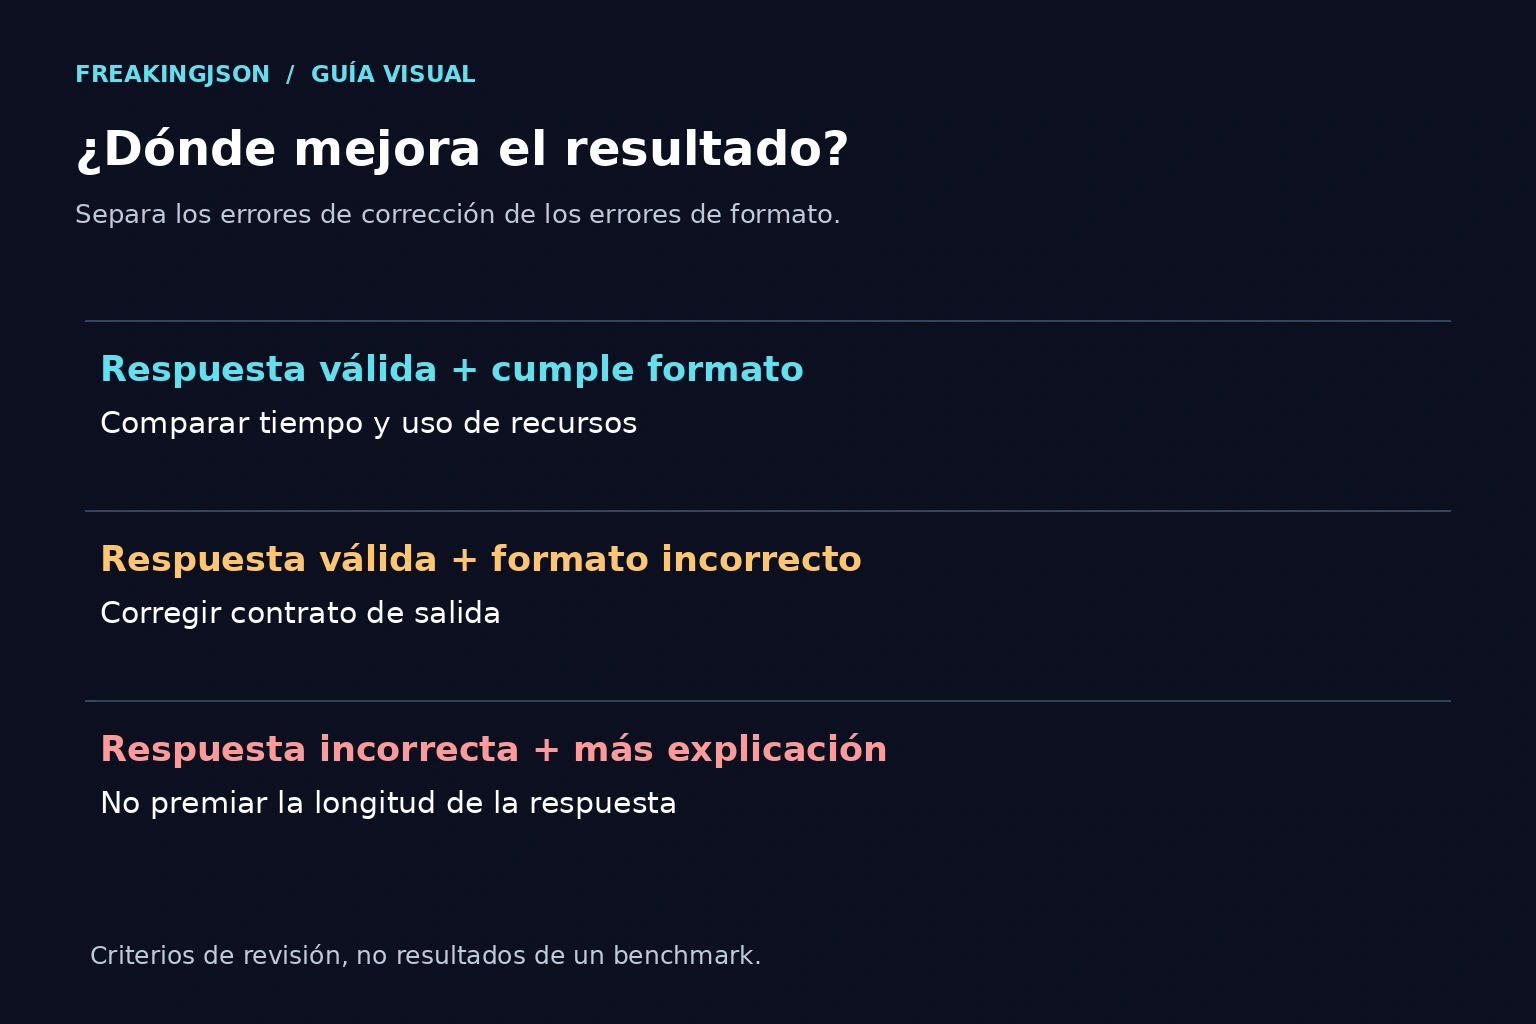
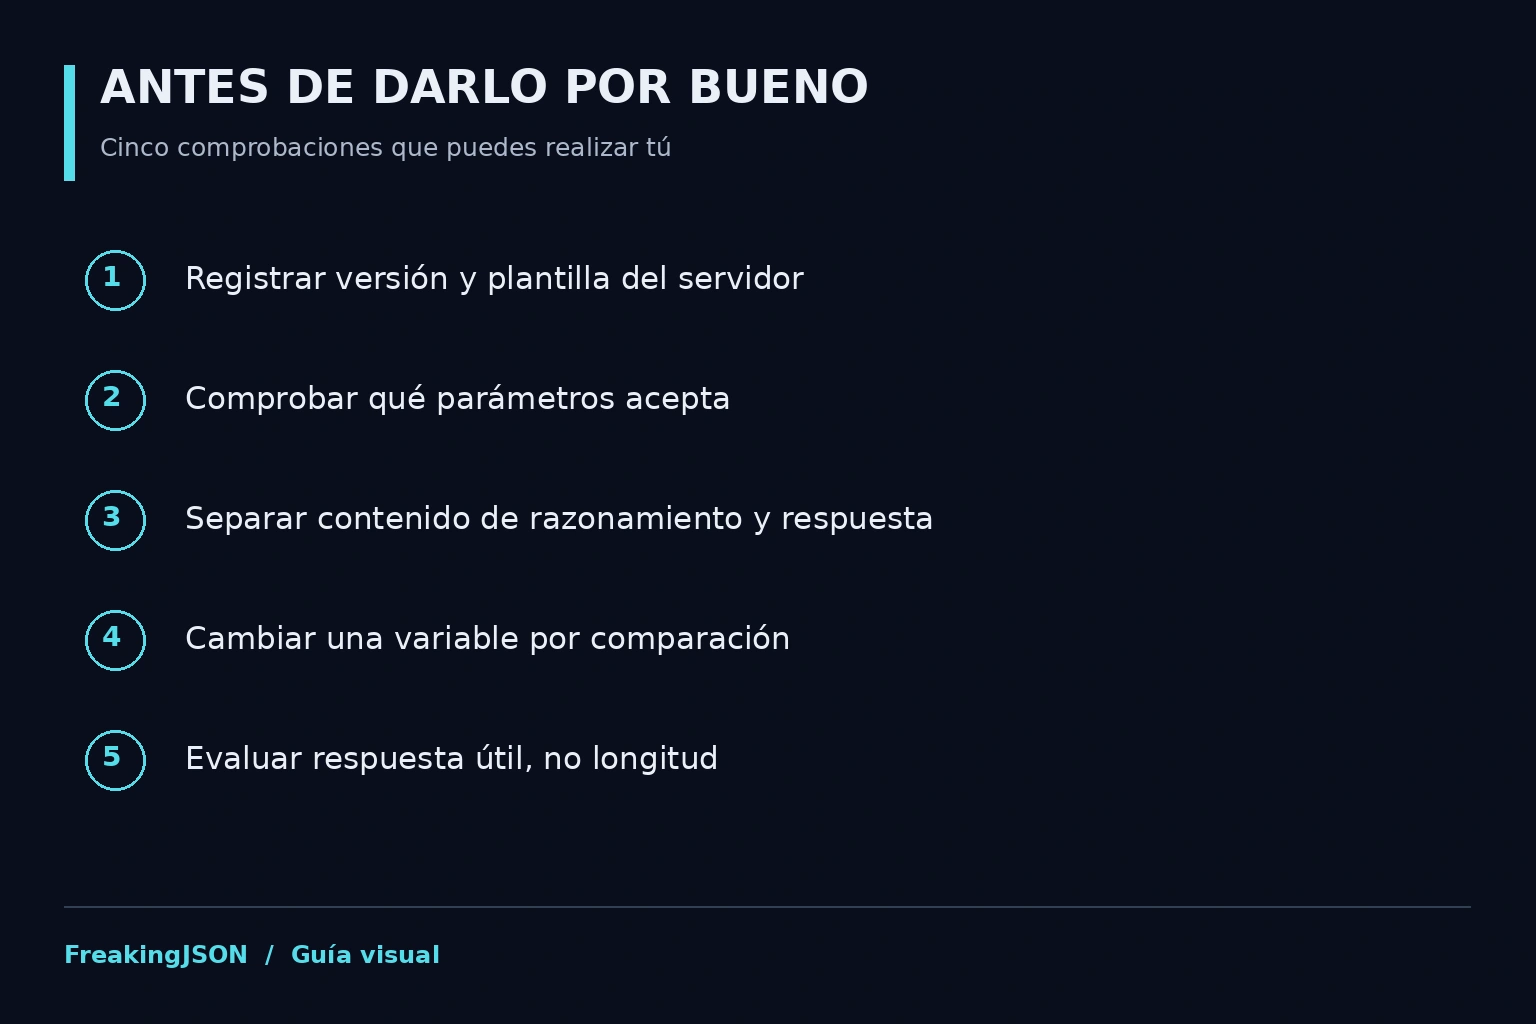
Elige tareas cuyo éxito puedas comprobar: una función con pruebas, una extracción con campos esperados o una explicación contrastable con una fuente. Conserva modelo, plantilla, prompt, contexto y límites. Cambia únicamente el nivel de esfuerzo si de verdad se admite. Repite y registra respuestas correctas, respuestas truncadas y duración.
Si cambias a la vez presupuesto, límite de salida, plantilla y esfuerzo, estás comparando dos configuraciones completas. Puede servir para escoger una que funcione, pero no demuestra que medium haya causado la mejora. Esta distinción impide convertir un diagnóstico local en una regla universal.
En tareas complejas, un presupuesto mayor puede ser útil. En tareas mecánicas, puede añadir espera sin cambiar el resultado. La decisión se toma con tus tareas, no con la longitud del pensamiento ni con una puntuación general.
Una secuencia práctica para recuperar salida útil
- Confirma la instalación: identifica modelo exacto, motor y plantilla.
- Prueba una petición sencilla: observa el JSON y el motivo de finalización.
- Da espacio suficiente: ajusta el límite según la documentación, sin asumir que todo es texto visible.
- Acota pensamiento si se admite: comprueba que el cambio llegue realmente al servidor.
- Vuelve a tu tarea real: valida contenido y latencia; guarda la configuración reproducible.
No hay aquí un número mágico de tokens. Un presupuesto razonable para una clasificación puede ser insuficiente para una demostración. Tu límite debe reflejar la tarea y el contrato del modelo, no copiar la cifra de otra máquina.
Regla de oro: primero haz que la respuesta llegue completa; después averigua cuánto razonamiento aporta valor.
Receta: separar pensamiento, respuesta y contexto
Entorno: llama.cpp con un modelo de razonamiento y plantilla de chat compatibles. Sustituye la ruta; confirma las opciones con llama-server --help. Un presupuesto no es una orden universal de calidad.
llama-server --model "/ruta/a/tu-modelo.gguf" \
  --jinja --ctx-size 4096 --parallel 1 --n-predict 1024 \
  --reasoning-budget 256 --reasoning-format deepseek \
  --host 127.0.0.1 --port 8087
--ctx-size 4096limita el contexto de esta prueba; no representa el máximo del modelo.--reasoning-budget 256asigna tokens al pensamiento cuando el modelo y la plantilla admiten ese control.--n-predict 1024limita la generación; deja margen para la respuesta final, no solo para razonar.--reasoning-format deepseeksepara el pensamiento enmessage.reasoning_content; no reduce por sí mismo el razonamiento.
En otra terminal, solicita una tarea breve:
curl --fail-with-body http://127.0.0.1:8087/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Da tres comprobaciones antes de cargar un GGUF."}],"max_tokens":1024}'
Comprueba choices[0].message.content y finish_reason. Si el final es length, no atribuyas una respuesta vacía automáticamente a un fallo del modelo. Repite cambiando solo el presupuesto y compara respuestas correctas, no longitud de pensamiento.
Es un punto de partida para comparar tu propio modelo, no un resultado de benchmark. Referencia: llama.cpp: servidor, formatos y presupuesto de razonamiento.
Preguntas frecuentes
¿Medium es siempre mejor que extra-high?
No. El resultado depende del modelo, la tarea y la implementación. Una comparación debe aislar el ajuste para atribuirle una mejora.
¿Una respuesta vacía significa que el modelo es malo?
No necesariamente. Revisa límites, campos de respuesta, plantilla y cortes del cliente.
¿Reasoning budget es la ventana de contexto?
No. El presupuesto de razonamiento y la capacidad de contexto cumplen funciones diferentes.
¿Se puede desactivar el pensamiento en todos los modelos?
No. Consulta el modelo y la implementación. Un control documentado para un modelo no garantiza soporte en otro.
Fuentes y siguientes lecturas
Documentación consultada el 14 de septiembre de 2026. Las capacidades corresponden a las versiones indicadas; comprueba la documentación de tu instalación.
- llama.cpp: formatos de razonamiento y presupuesto
- Qwen3-30B-A3B: modos de pensamiento
- Documentación de Qwen
- Transformers: configuración de generación
- IA local sin humo: elegir a partir de pruebas
- Prefill, razonamiento y decode: no confundas las métricas
- Modelos, interfaces y agentes: qué estás eligiendo
- Qué comprobar en un modelo para programar
El conocimiento verdadero trasciende a lo público 🌀
¿Quieres seguir la línea de investigación? Continúa con artículos relacionados y guarda esta lectura para volver después.
Ver relacionados