En este artículo
Que un modelo tenga 35.000 millones de parámetros no significa que necesite ejecutar todos en cada token. Tampoco significa que puedas guardar solo los que usa en ese instante. Para elegir entre un modelo denso y uno con expertos, separa tamaño de los pesos, memoria de trabajo y calidad en tu tarea.
En corto: el archivo no es toda la memoria: reserva contexto y buffers.
La primera cuenta: pesos, no memoria total
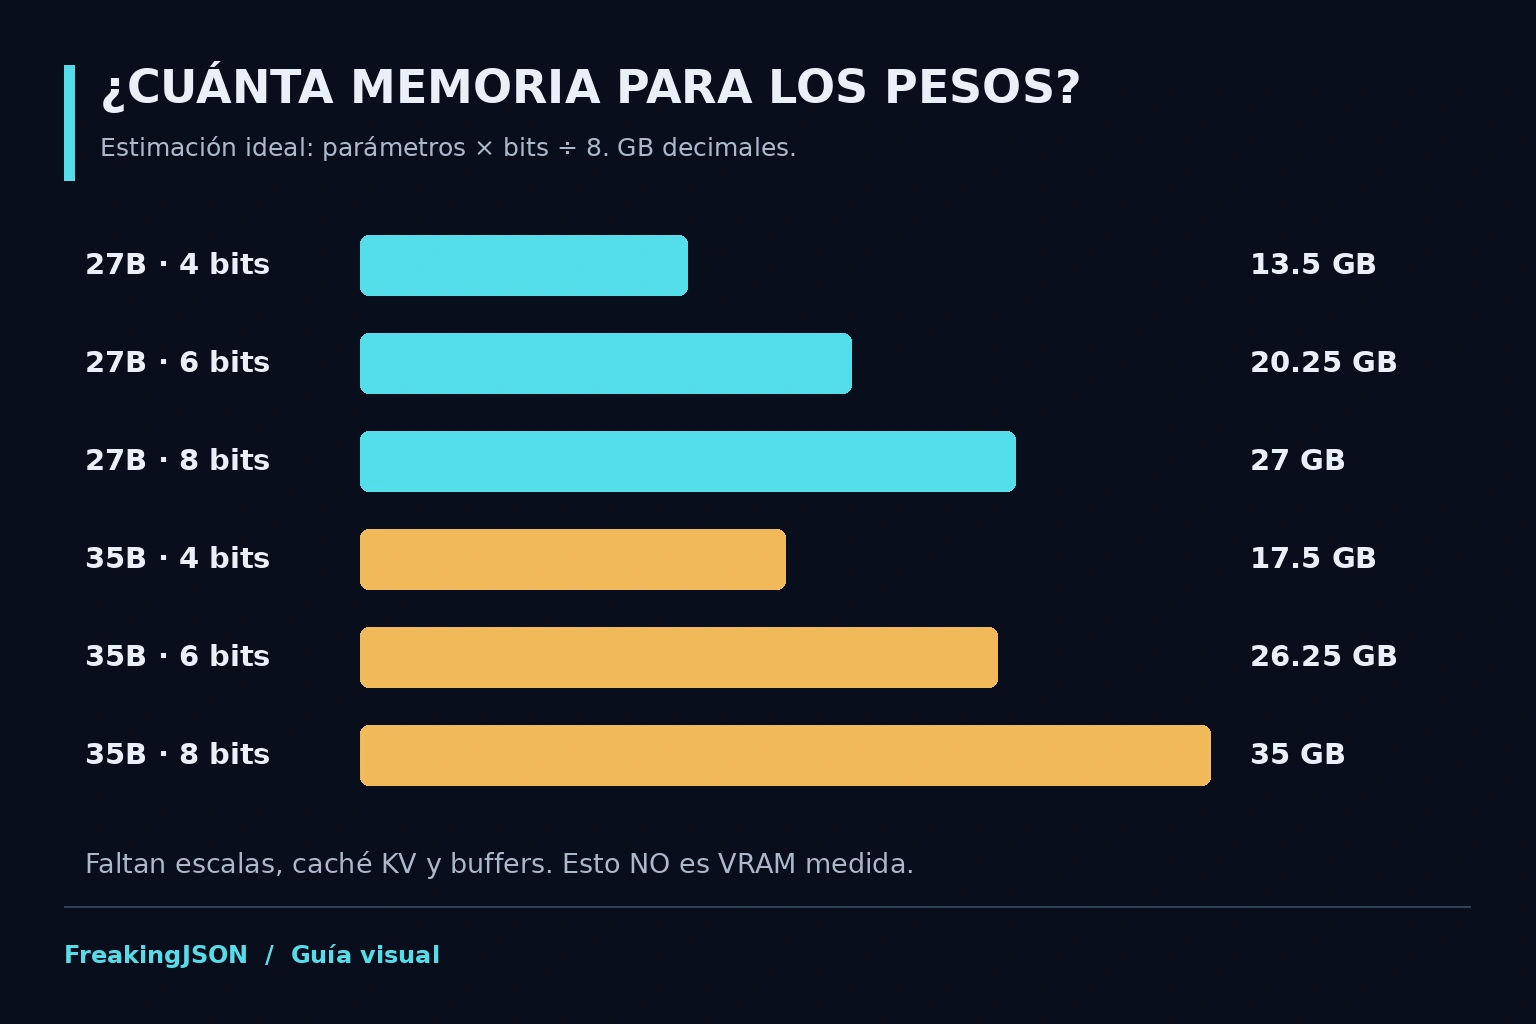
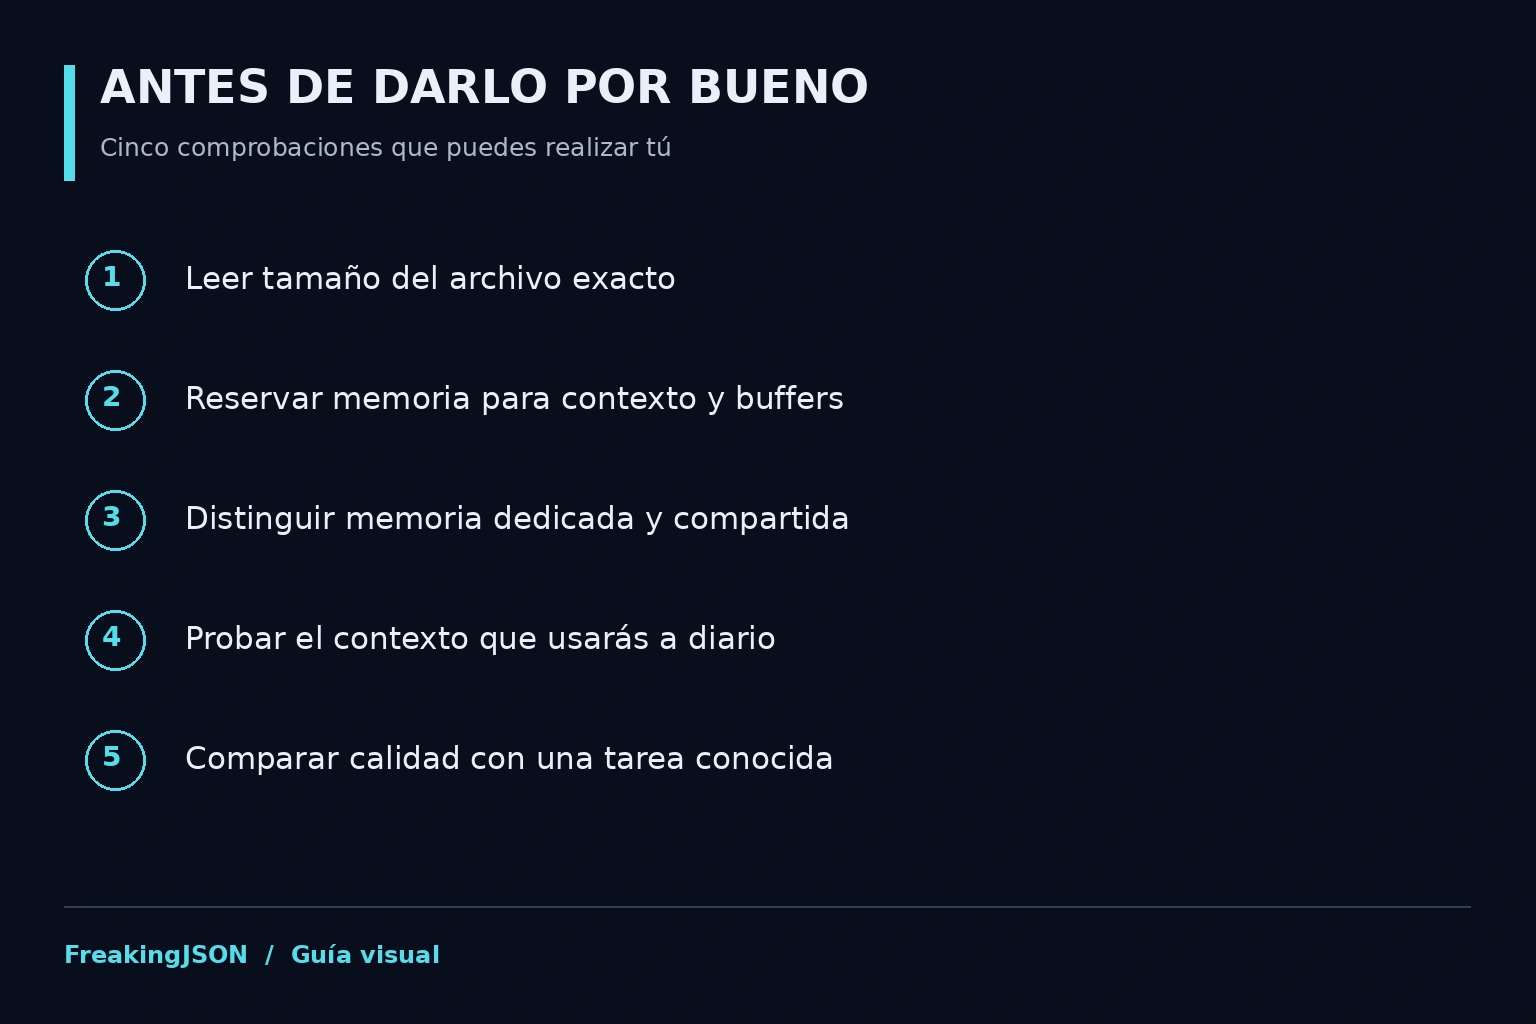
Una estimación inicial de almacenamiento es parámetros multiplicados por bits por parámetro, dividido entre ocho. Es una cuenta idealizada: no incluye escalas de cuantización, metadatos, tensores guardados con mayor precisión ni otras estructuras. El tamaño del archivo concreto es más fiable para planear una descarga.
Para ejecutar el modelo, reserva además caché KV, buffers del motor, contexto y memoria de otras aplicaciones. Un archivo que cabe por poco en una GPU puede fallar al procesar una conversación larga. Distingue GB decimales de GiB: no son unidades idénticas.
MoE: menos trabajo activo no significa menos pesos
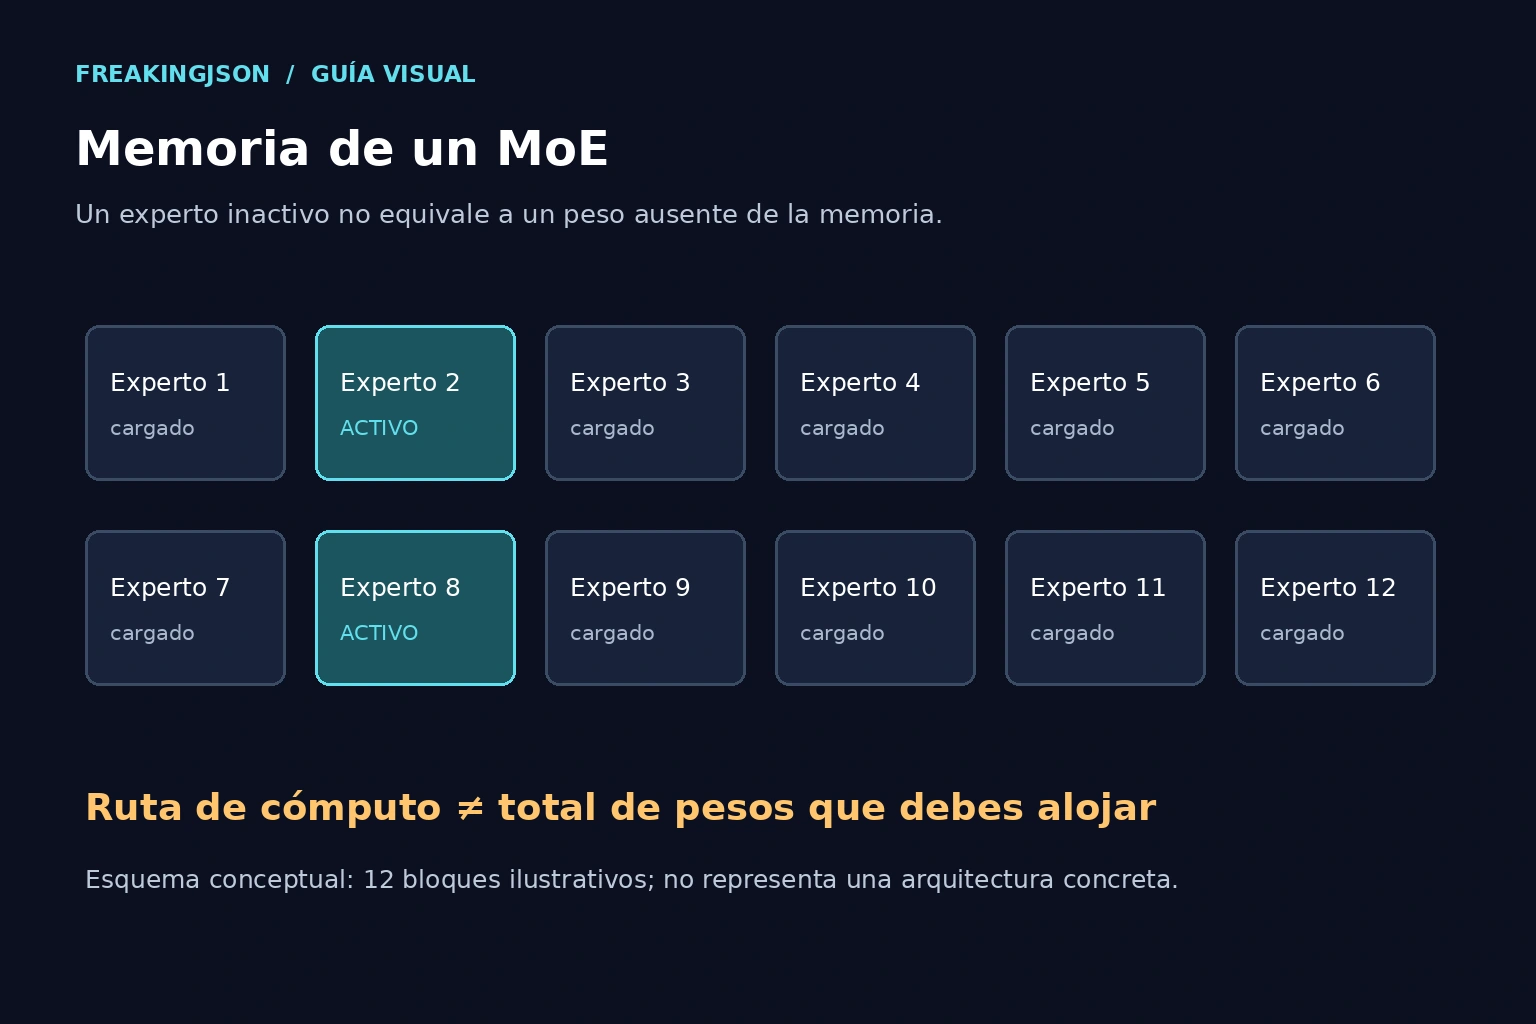
Un modelo Mixture-of-Experts activa un subconjunto de expertos por token. Eso puede reducir el cálculo frente a ejecutar todos sus parámetros, pero el conjunto completo sigue formando parte del modelo. Dependiendo del motor, los expertos pueden residir en GPU, RAM o una combinación; mover datos también tiene un coste.
«Número de parámetros: 30,5 mil millones en total y 3,3 mil millones activados». — tarjeta oficial de Qwen3-30B-A3B; traducción propia.
Ese ejemplo concreto documenta también 128 expertos, ocho activados y 32.768 tokens de contexto nativo. No lo confundas con otra generación ni conviertas el tamaño activo en una promesa de velocidad equivalente a un modelo denso de 3B. Influyen arquitectura, ancho de banda, implementación y carga.
| Dimensión | Denso | Con expertos |
|---|---|---|
| Cálculo por token | Utiliza la red densa | Selecciona una parte de los expertos |
| Pesos que almacenar | Modelo completo | Modelo completo, no solo expertos activos |
| Velocidad | Se mide con la tarea y hardware | También se mide; no se deduce del nombre |
| Elección | Calidad y presupuesto reales | Calidad, enrutamiento y coste de mover pesos |
GPU dedicada, RAM y memoria compartida
Una GPU con VRAM dedicada no es equivalente a un equipo con la misma cantidad de RAM del sistema. Si parte del modelo queda en CPU, cambia el recorrido de los datos y puede aumentar la latencia. En un equipo de memoria compartida, CPU y GPU compiten por el mismo espacio: el sistema operativo y tus aplicaciones no desaparecen.
Al evaluar una configuración, registra cuánto queda libre después de cargar, cuánto consume con el contexto objetivo y si empieza a utilizar intercambio en disco. El éxito al arrancar no prueba que una sesión larga vaya a mantenerse estable.
Para un usuario con poca memoria, un modelo menor que completa la tarea sin descargas continuas de capas puede ser mejor elección. Para quien necesita mayor calidad y tolera latencia, cargar un modelo mayor parcialmente en RAM puede ser una opción consciente, no un fallo.
Cuándo compensa subir de tamaño
El salto tiene sentido si puedes demostrar una mejora en aquello que te cuesta corregir: seguimiento de instrucciones, extracción de un documento difícil o solución de código que pasa pruebas. No basta con que la respuesta parezca más detallada. Un modelo mayor también puede equivocarse con más confianza.
Prueba el mismo conjunto de tareas con tu modelo actual y el candidato. Incluye una conversación del tamaño que usarás normalmente y una respuesta suficientemente larga para detectar truncamiento. Compara aciertos y tiempo total; después añade memoria pico. Si necesitas varias iteraciones, cuenta todas, no solo la primera generación.
Una decisión sin tabla de ganadores universales
Quédate con el modelo menor si ya resuelve bien la tarea, si necesitas respuesta inmediata o si el mayor obliga a cerrar herramientas esenciales. Prueba el mayor si el margen de memoria permite el contexto real y observas una mejora que reduce tu trabajo de revisión.
Para modelos cuantizados, guarda el nombre completo del archivo y la fuente. «Q4» no describe por sí solo todas las decisiones de representación. Usa la misma evaluación para comprobar si una cuantización más compacta conserva lo que necesitas; la pérdida no es idéntica en todos los modelos y tareas.
Antes de descargar, revisa licencia, formato compatible, tamaño total y versión mínima del motor. Es más barato detectar incompatibilidad leyendo la tarjeta que descubrirla después de descargar decenas de gigabytes.
Regla de cierre: no compres parámetros. Compra margen para ejecutar bien las tareas que realmente necesitas.
Receta: presupuesto de memoria antes de cargar
Comprueba primero el tamaño del GGUF en disco. Esta cuenta Python es orientativa para los pesos, no para la RAM/VRAM total ni para garantizar que un archivo quepa:
for parametros_b in (27, 35):
    for bits in (4, 6):
        gib = parametros_b * 1_000_000_000 * bits / 8 / (1024 ** 3)
        print(f"{parametros_b}B a {bits} bits: {gib:.2f} GiB teóricos de pesos")
El cálculo ignora escalas, metadatos y tensores guardados a otras precisiones. Añade margen para contexto, buffers, sistema operativo y otras aplicaciones. En MoE, usa el número de parámetros totales para estimar almacenamiento, no únicamente los activos por token.
Primera carga: contexto contenido y una sola solicitud
llama-server --model "/ruta/a/tu-modelo.gguf" \
  --ctx-size 4096 --parallel 1 --n-predict 512 \
  --host 127.0.0.1 --port 8087 --gpu-layers auto
Ejecuta solo si ya has confirmado memoria suficiente y soporte del modelo/backend. auto solicita selección automática de capas en versiones compatibles; no equivale a una garantía de encaje. Revisa el registro y el consumo real. Si el sistema empieza a paginar de forma sostenida, detén la prueba y reduce tamaño/contexto: no compares velocidad durante un intercambio continuo con disco.
Guías: flags y carga de llama.cpp y ejemplo documentado de un modelo MoE y sus requisitos.
Preguntas frecuentes
¿Un modelo 27B a 4 bits cabe en 16 GB de VRAM?
La cuenta ideal de pesos no basta para garantizarlo. Debes sumar estructuras de cuantización, caché y buffers y comprobar el archivo y motor concretos.
¿Un MoE de 35B ocupa lo mismo que sus parámetros activos?
No. Los parámetros activos explican parte del cálculo; no representan todo el modelo que hay que almacenar.
¿Q8 siempre es mejor elección que Q4?
No necesariamente para tu equipo. Compara calidad útil y memoria con la tarea real.
¿Puedo usar RAM cuando no cabe todo en GPU?
Algunos motores permiten repartir capas o expertos. El rendimiento cambia y debe comprobarse en esa configuración.
Fuentes y siguientes lecturas
Documentación consultada el 14 de septiembre de 2026. Las capacidades corresponden a las versiones indicadas; comprueba la documentación de tu instalación.
- Tarjeta oficial: Qwen3-30B-A3B
- llama.cpp: ejecución y formatos locales
- Servidor llama.cpp: caché, contexto y descarga de expertos
- Transformers: panorama de cuantización
- IA local sin humo: elegir a partir de pruebas
- Prefill, razonamiento y decode: no confundas las métricas
- Modelos, interfaces y agentes: qué estás eligiendo
- Qué comprobar en un modelo para programar
El conocimiento verdadero trasciende a lo público 🌀
Continúa explorando Inteligencia Artificial con piezas relacionadas y evidencia adicional.
Ver relacionados