
En este artículo

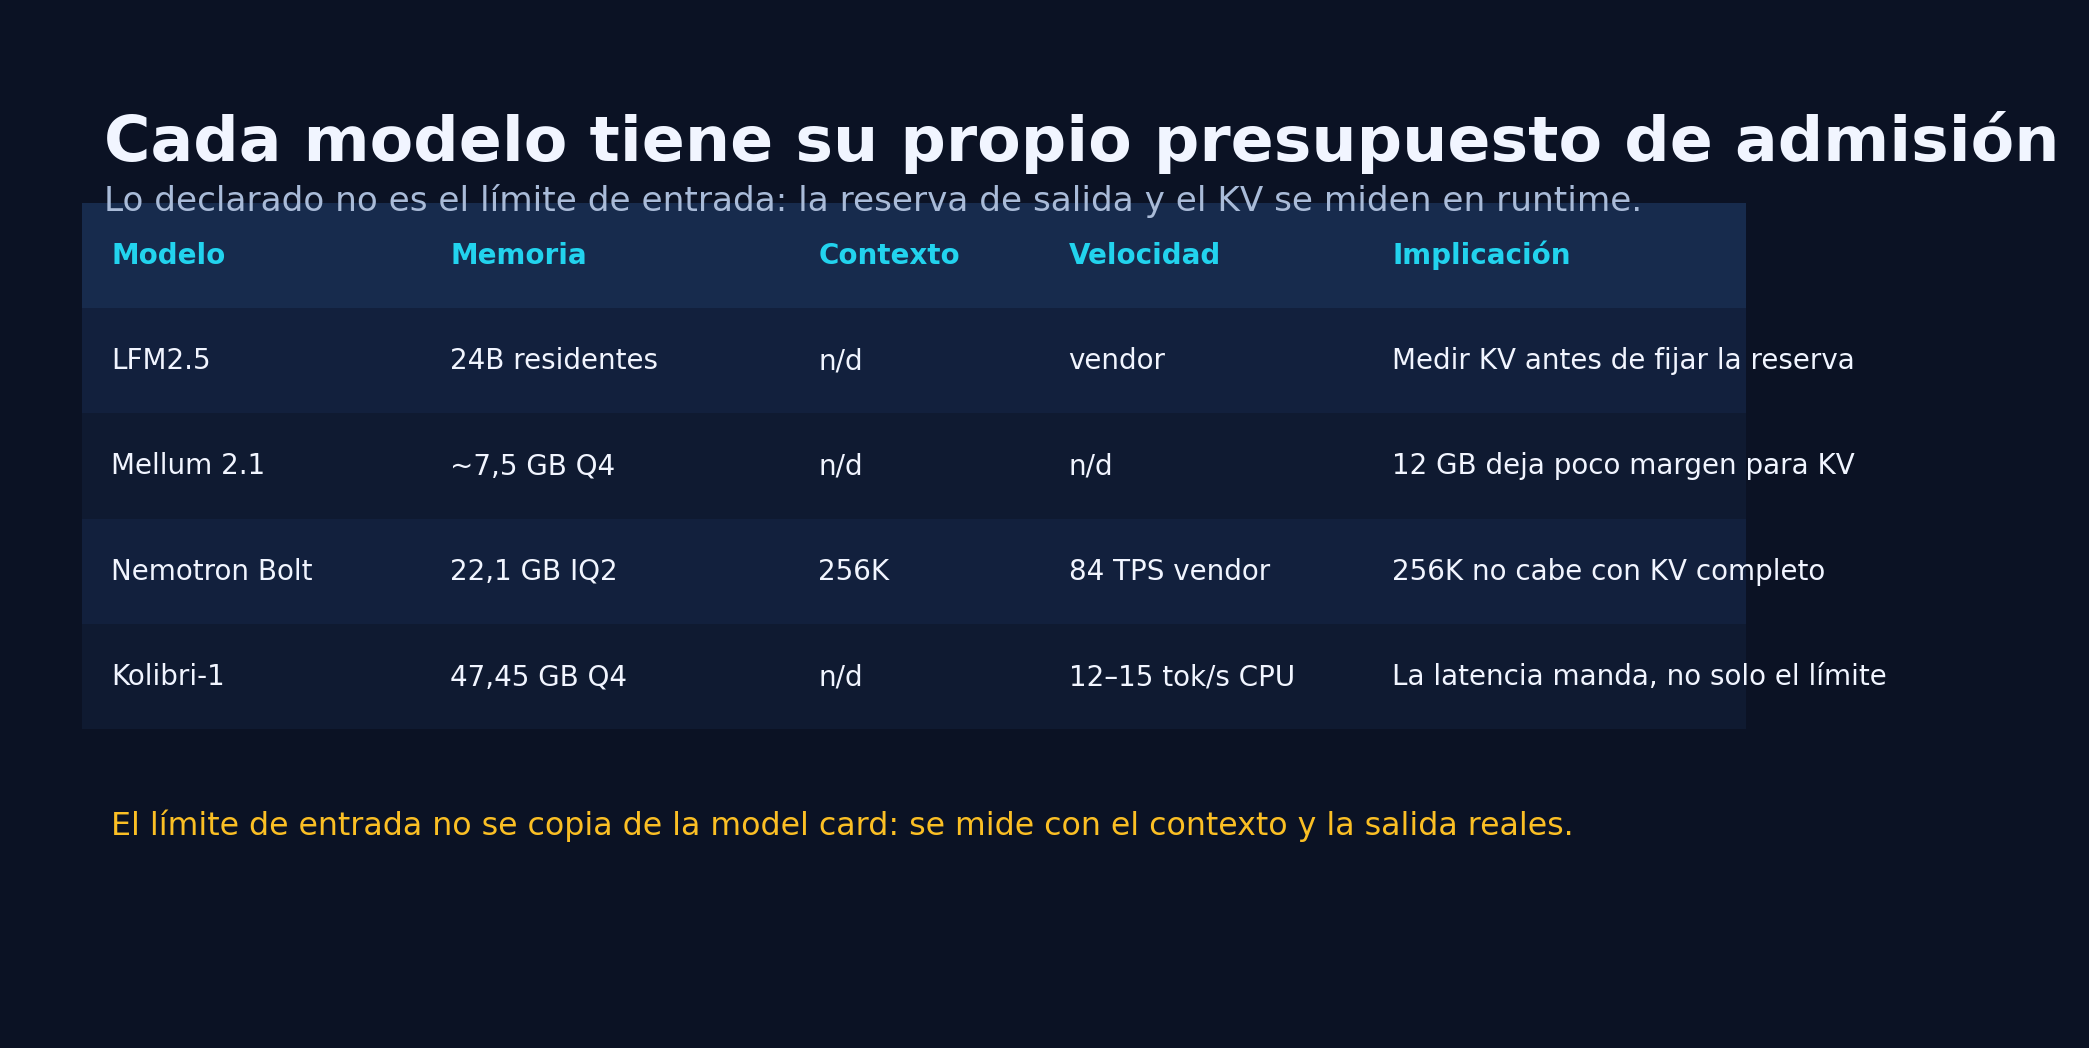
No todos los modelos locales necesitan una GPU. Kolibri-1 propone otro eje: un MoE de 78,1B parámetros totales y 3,46B activos que, en Q4, pesa 47,45 GB y cabe en una máquina de 64 GB de RAM. La promesa es atractiva; la pregunta es si la latencia alcanza para el uso que tienes en mente.
La promesa
La promesa de Kolibri-1 es simple: un modelo grande, sin GPU dedicada. La letra pequeña también: el modelo completo tiene que estar en RAM, no solo los expertos activos. Si el archivo pesa 47,45 GB, una máquina de 16 GB no puede con él por mucho que el router active solo 3,46B por token.
Eso lo convierte en un modelo para workstations y Macs de 64 GB, no para laptops de consumo. La distinción es importante porque la conversación sobre “modelos locales” suele mezclar capacidad, latencia y precio del hardware. Kolibri ataca la capacidad y el precio; la latencia es otro problema.

Qué es Kolibri-1
Kolibri-1 es un modelo de 78,1B parámetros totales con 3,46B activos por token, publicado bajo Apache 2.0. La arquitectura es de mezcla de expertos: un router selecciona una fracción de la red para cada token, y el resto permanece residente pero inactivo.
El número que importa para la memoria es 78,1B, no 3,46B. El número que importa para el cómputo es 3,46B. Son dos presupuestos distintos y conviene no confundirlos. Un modelo puede ser barato de calcular y caro de almacenar; Kolibri es exactamente eso.
“El bajo número de activos reduce el cómputo por token, pero el modelo completo debe residir en RAM.” — Regla de hardware.
Por qué cabe en RAM
El quant Q4_K_M reduce los pesos a 47,45 GB. En una máquina de 64 GB, eso deja unos 16 GB para el sistema operativo, el contexto y los buffers. No es un margen enorme, pero es suficiente para sesiones de contexto moderado. En un Mac de 64 GB, la memoria unificada permite que la CPU y la GPU compartan el mismo espacio, lo que simplifica el despliegue.
La clave es que el modelo no necesita una GPU dedicada para funcionar. La CPU puede hacer el cómputo, y la RAM sostiene los expertos. La GPU, si existe, acelera; no es un requisito. Eso abre la puerta a workstations y servidores pequeños que ya están en una oficina.
La RAM no es solo capacidad; también es ancho de banda. Un servidor con 64 GB de DDR4 y un Mac con memoria unificada pueden cargar el mismo archivo y comportarse distinto. La memoria unificada evita copias entre CPU y GPU, pero no es infinita: el sistema operativo y el contexto compiten por el mismo espacio. La latencia real depende de esa arquitectura, no solo del número de gigabytes.
Qué latencia esperar
El rundown reporta 12–15 tokens por segundo en CPU. Es una cifra de terceros, no una medición propia, y depende del hardware, del contexto y del quant. Para lectura asistida o generación de texto en segundo plano, puede ser suficiente. Para un agente interactivo que hace varias llamadas por turno, es lento.
La latencia no escala solo con los parámetros activos. También depende del ancho de banda de memoria y de la eficiencia del runtime. Un MoE de 3,46B activos puede ser más rápido que un denso de 3,46B si el router elige bien, pero sigue leyendo pesos de una memoria más lenta que la VRAM. La cifra de 12–15 tok/s es un orden de magnitud, no una promesa.
El contexto cambia la cuenta. A medida que la conversación crece, el modelo necesita mantener más estado y el runtime reserva más memoria. El margen de 16 GB que queda después de los pesos se reduce. En una sesión larga, el límite práctico no es el tamaño del archivo, sino el archivo más el contexto. Mide con el contexto que usas, no con el mínimo. Ese es el límite real.
Para qué sirve y para qué no
Sirve para tareas de texto que toleran espera: resúmenes, clasificación, generación de borradores, análisis de documentos largos. También para entornos donde no hay GPU y se quiere mantener el dato en local. La combinación de 78B y Apache 2.0 es atractiva para equipos que necesitan un modelo grande sin depender de una API.
No sirve para agentes interactivos de baja latencia, ni para generación de código en tiempo real, ni para aplicaciones donde el usuario espera una respuesta instantánea. Tampoco reemplaza una GPU para cargas de visión o imágenes. Es un modelo de texto, en CPU, con un presupuesto de memoria concreto.
La decisión práctica es medir el caso de uso. Si tu flujo tolera 12–15 tok/s, Kolibri puede ser una opción. Si necesita 50 tok/s, no. La capacidad de correr el modelo no es lo mismo que la capacidad de usarlo.
Cómo probarlo
Antes de descargar 47 GB, verifica tres cosas: que tu máquina tenga 64 GB de RAM (o memoria unificada), que el runtime soporte el formato del modelo y que el contexto que necesitas quepa en el margen que queda. Después, mide la latencia con el contexto real, no con un prompt de una línea.
La prueba útil es una tarea completa: un documento de 10.000 tokens, un resumen, una segunda pasada de corrección. Mide el tiempo total y la calidad. Si el resultado es aceptable y el tiempo entra en tu flujo, el modelo sirve. Si no, el siguiente paso es un modelo más pequeño o una GPU.
Para seguir leyendo
El rundown de modelos abiertos para home lab tiene la tabla completa de requisitos y latencias reportadas. La licencia Apache 2.0 explica qué se puede hacer con el modelo. Si te interesa el 2-bit, revisa el mapa de octubre; para el caso de 12 GB, Mellum 2.1; y para el de 24 GB, Nemotron 3.5 Bolt.
Preguntas frecuentes
¿Kolibri-1 corre en 16 GB de RAM?
No. El quant Q4 pesa 47,45 GB; el modelo completo tiene que estar residente. La cifra de 3,46B activos describe cómputo, no memoria.
¿Necesito una GPU?
No para cargarlo. La CPU puede hacer el cómputo; una GPU acelera, pero no es un requisito. La latencia en CPU es el límite práctico.
¿Sirve para agentes?
Para agentes que toleran espera y pocas iteraciones, puede servir. Para agentes interactivos con muchas llamadas por turno, 12–15 tok/s es demasiado lento.
El conocimiento verdadero trasciende a lo público 🌀
Continúa explorando Inteligencia Artificial con piezas relacionadas y evidencia adicional.
Ver relacionados