
En este artículo

El agente responde. El banner dice que todo salió bien. Pero el modelo que respondió no es necesariamente el que pediste. Si el proveedor primario falló y la cadena activó un respaldo, la respuesta puede venir de otro modelo, con otro costo y otra calidad. Sin atribución, no hay forma de saberlo.
El problema
Una cadena de proveedores existe para mantener la disponibilidad. Si el primario se cae, el sistema prueba un respaldo; si ese falla, prueba otro. Para el usuario, la experiencia es continua. Para la operación, la respuesta puede haber cambiado de modelo, de precio y de comportamiento sin que nadie lo note.
“La atribución no es lo que el agente cree que usó; es lo que el sistema puede probar.” — Principio de operación.
Eso no es un fallo malicioso. Es una consecuencia de diseñar para disponibilidad sin diseñar para atribución. El sistema sabe que respondió; no sabe —o no registra— quién respondió. La diferencia importa cuando se audita un costo, se compara calidad o se investiga un comportamiento extraño.
La opacidad tiene un costo operativo. Si un equipo no sabe qué modelo respondió, no puede comparar proveedores, ni detectar una degradación silenciosa, ni defender una factura. La atribución no es un lujo de auditoría: es la base para tomar decisiones sobre costo y calidad. Sin ella, la cadena de fallback es una caja negra que funciona hasta que deja de hacerlo.
Por qué el banner no basta
El banner de una CLI muestra la configuración: el modelo que el usuario pidió o el que el archivo de configuración declara. No muestra el modelo que el proveedor usó para esa respuesta. Son dos cosas distintas. Un banner puede decir “modelo A” mientras la respuesta vino del modelo B porque el primario estaba caído.
Lo mismo pasa con un HTTP 200. El código de estado prueba que hubo una respuesta, no que el modelo fue el solicitado. La disponibilidad y la atribución son dimensiones separadas. Confundirlas es la raíz de la mayoría de los receipts incompletos.
El banner tampoco distingue entre “modelo configurado” y “modelo disponible”. Un proveedor puede anunciar un modelo y servir una versión distinta por capacidad, por región o por una caída parcial. La única defensa es leer el campo de modelo en la respuesta y contrastarlo con el receipt.

Qué es una cadena de fallback
Una cadena de fallback es una lista ordenada de proveedores o modelos. El sistema intenta el primero; si falla por error de red, cuota o timeout, pasa al siguiente. El objetivo es que el servicio siga disponible aunque una pieza se rompa.
El problema es que la cadena puede mezclar modelos con capacidades distintas. Un respaldo puede tener menos contexto, otra ventana de salida o un tokenizer diferente. La respuesta puede ser válida y, aun así, no ser equivalente. La atribución es lo que permite detectar esa diferencia.
Un ejemplo concreto: la cadena tiene un primario y cuatro respaldos. El primario falla por timeout; el primer respaldo responde con un modelo más pequeño. El usuario ve una respuesta válida, pero el costo por token y la calidad cambiaron. Si el sistema no registra el intento, el equipo de operaciones no puede explicar por qué la factura subió o por qué la calidad bajó en esa sesión.
Cómo verificar el modelo servido
La verificación correcta tiene tres pasos. Primero, aislar la configuración del usuario para que la cadena sea la que el operador cree que es. Segundo, hacer una llamada directa al proveedor y leer el campo de modelo servido en la respuesta. Tercero, registrar ese dato en un receipt que no dependa de lo que el agente cree que usó.
El aislamiento es clave. Si la configuración del usuario puede inyectar un fallback, la prueba deja de ser reproducible. Un runner con una configuración controlada permite atribuir la respuesta a una cadena concreta. Sin aislamiento, el resultado es una anécdota.
El receipt mínimo
Un receipt útil registra, como mínimo, el proveedor, el modelo servido, el número de intento, si se usó un fallback, la latencia y un identificador de trazabilidad. Con esos campos se puede responder qué pasó, cuándo y por qué. Sin ellos, el receipt es un log decorativo.
| Campo | Qué prueba |
|---|---|
| provider | Quién atendió la solicitud |
| served_model | Qué modelo respondió |
| attempt | Número de intento |
| fallback_used | Si se activó la cadena |
| latency | Costo temporal |
| receipt_id | Trazabilidad |
El receipt también necesita retención. Un dato que se borra a las 24 horas no sirve para auditar un costo mensual. Define cuánto tiempo se guarda, dónde y quién puede leerlo. La atribución sin retención es una foto; la operación necesita una película.
Errores comunes
El primero es confiar en el banner. El segundo es usar un solo éxito como prueba permanente: que el primario respondiera ayer no significa que responda hoy. El tercero es mezclar disponibilidad con atribución: un 200 no dice qué modelo respondió. El cuarto es no aislar la configuración, lo que convierte la prueba en un experimento no reproducible.
El quinto es no registrar el intento. Si la cadena tiene cuatro pasos y solo se guarda el resultado final, no se puede saber cuántos fallbacks se activaron ni cuánto costó la disponibilidad. El sexto es no auditar el receipt: un dato que nadie lee no mejora nada.
La verificación debe ser reproducible. Eso significa que otra persona, con la misma configuración aislada y la misma llamada, debe obtener el mismo modelo servido. Si el resultado depende de la configuración del usuario, de la hora o de un estado interno, no es una verificación: es una coincidencia. El receipt es lo que convierte la coincidencia en evidencia. La evidencia es la única salida. Sin ella, no hay atribución posible. Ese es el contrato.
Para seguir leyendo
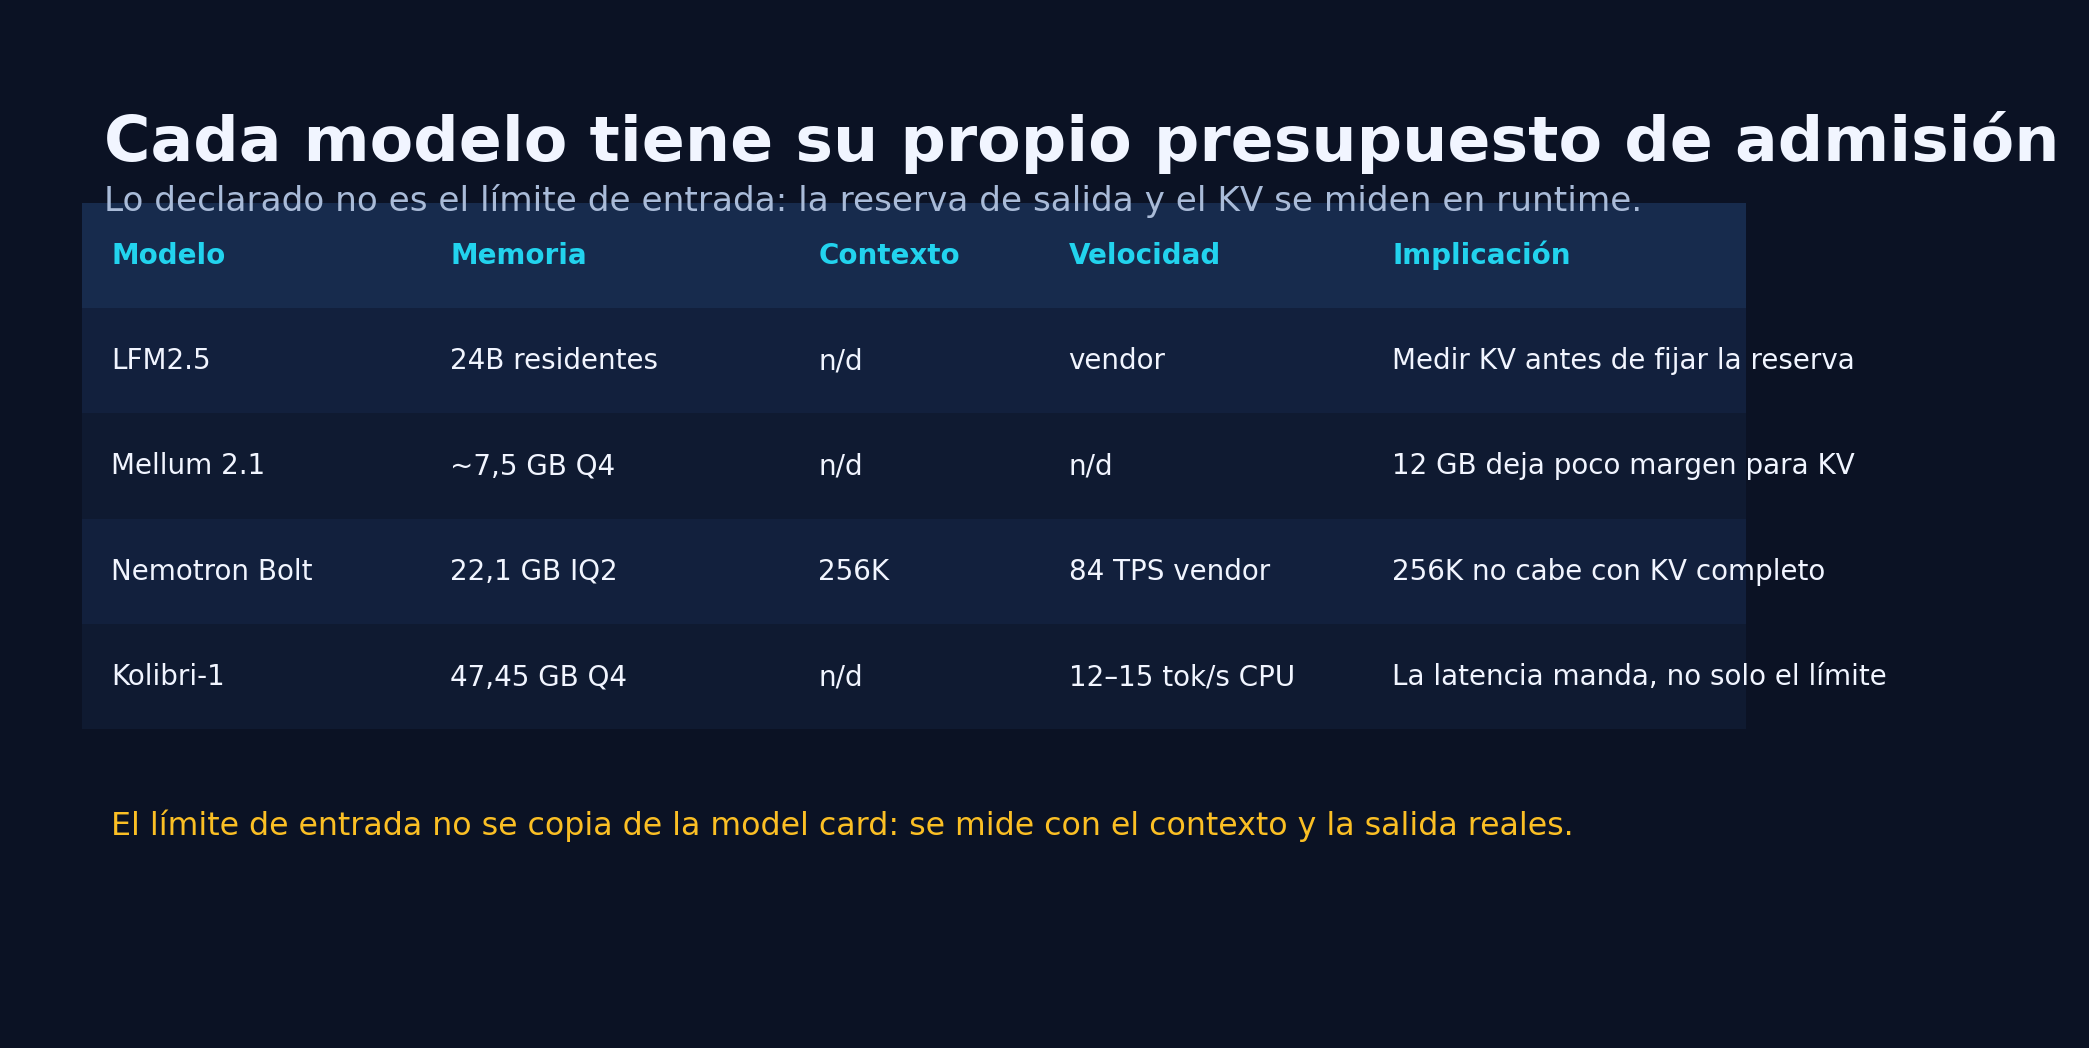
La documentación de la respuesta de chat muestra el campo de modelo servido; la documentación de routing explica cómo funcionan las cadenas de fallback. Si te interesa el contrato de admisión, revisa medir antes de enviar. Para el contexto que se rompe, checkpoint y compactación. Y para elegir modelos de agente, LFM2.5 y los 2B activos.
Preguntas frecuentes
¿Un fallback es siempre malo?
No. Es una estrategia de disponibilidad. El problema no es el fallback, sino la falta de atribución: no saber que se activó y qué modelo respondió.
¿El campo de modelo de la respuesta es suficiente?
Es la mejor señal disponible, pero no prueba calidad ni intención. Debe combinarse con el proveedor, el intento y un receipt reproducible.
¿Cómo evito que la configuración del usuario cambie la cadena?
Aislando la configuración en un runner controlado. Sin aislamiento, la prueba no es reproducible y la atribución se vuelve una anécdota.
El conocimiento verdadero trasciende a lo público 🌀
Continúa explorando Inteligencia Artificial con piezas relacionadas y evidencia adicional.
Ver relacionados