
En este artículo

La proeza es fácil de resumir: un modelo de 74.000 millones de parámetros, con 9.000 millones activos, comprimido hasta 22,1 GB para que quepa en una GPU de 24 GB. La parte difícil es la que no cabe en el titular: qué se pierde en la compresión y cuánto contexto queda cuando el KV cache empieza a ocupar espacio.
La apuesta
NVIDIA eligió un camino distinto al de la mayoría. En vez de entrenar un modelo más pequeño a 4 bits, tomó un modelo grande y lo comprimió de forma agresiva: expertos en IQ2_XXS, capas Mamba en NVFP4, embeddings y salida en Q8. El resultado es un checkpoint de 22,1 GB que conserva la arquitectura y las capacidades del modelo original.
La tesis es de Pareto: un modelo más grande a 2 bits puede ser mejor que uno más pequeño a 4 bits para el mismo presupuesto de memoria. No es una afirmación universal; es una hipótesis que NVIDIA respalda con ablations. La compresión es con pérdida por diseño, y el fabricante lo dice sin rodeos.
“Quantization is lossy by design.” — Reporte técnico de Nemotron 3.5 Bolt, 15-oct-2026.

Qué es Nemotron Bolt
Nemotron 3.5 Bolt es un híbrido Mamba-Transformer de 74B parámetros totales y 9B activos por token. Tiene hasta 256K de contexto y capacidades de visión. La mezcla de capas de estado (Mamba) y atención busca reducir el costo de contexto largo sin renunciar a la calidad de atención donde importa.
El modelo se publica bajo OpenMDW-1.1, con GGUF oficial y un checkpoint BF16 para post-entrenamiento. Eso importa porque no es solo una demo: hay pesos, hay formato y hay una ruta de despliegue. La licencia no es Apache, así que conviene leerla antes de usarlo comercialmente.
Cómo cabe en 24 GB
El truco no es un solo quant: es una mezcla. Los expertos van a IQ2_XXS, con 2,0625 bits efectivos. Las capas Mamba van a NVFP4, con 4 bits. Los embeddings y la salida van a Q8. Esa distribución reduce el peso total de 148 GB en BF16 a 22,1 GB, un 85,1% menos.
La decisión de comprimir más los expertos y menos las capas críticas es deliberada. Los expertos son la mayor parte del modelo y toleran mejor la cuantización agresiva; las capas de estado y las proyecciones necesitan más precisión para no degradar la calidad. El resultado es un compromiso, no una compresión uniforme.
El rendimiento declarado depende además de un drafter LiLiCorr para decodificación especulativa. Eso significa que parte de la velocidad viene de un modelo auxiliar que propone tokens y el modelo grande verifica. Si el drafter no está disponible o no coincide con la distribución, la ventaja se reduce. No es magia: es una técnica que hay que configurar y medir.
Qué se pierde al comprimir
La primera pérdida es de calidad. IQ2_XXS es una cuantización muy agresiva; en tareas de razonamiento fino, código o matemáticas, la degradación puede ser visible. NVIDIA argumenta que un modelo más grande a 2 bits sigue siendo competitivo frente a uno más pequeño a 4, pero esa comparación depende de la tarea y del benchmark.
La segunda pérdida es de precisión en los bordes. Los expertos comprimidos pueden fallar en tokens raros, nombres propios o contextos que el router no vio durante el entrenamiento. No es un fallo catastrófico; es una erosión que se nota en usos exigentes.
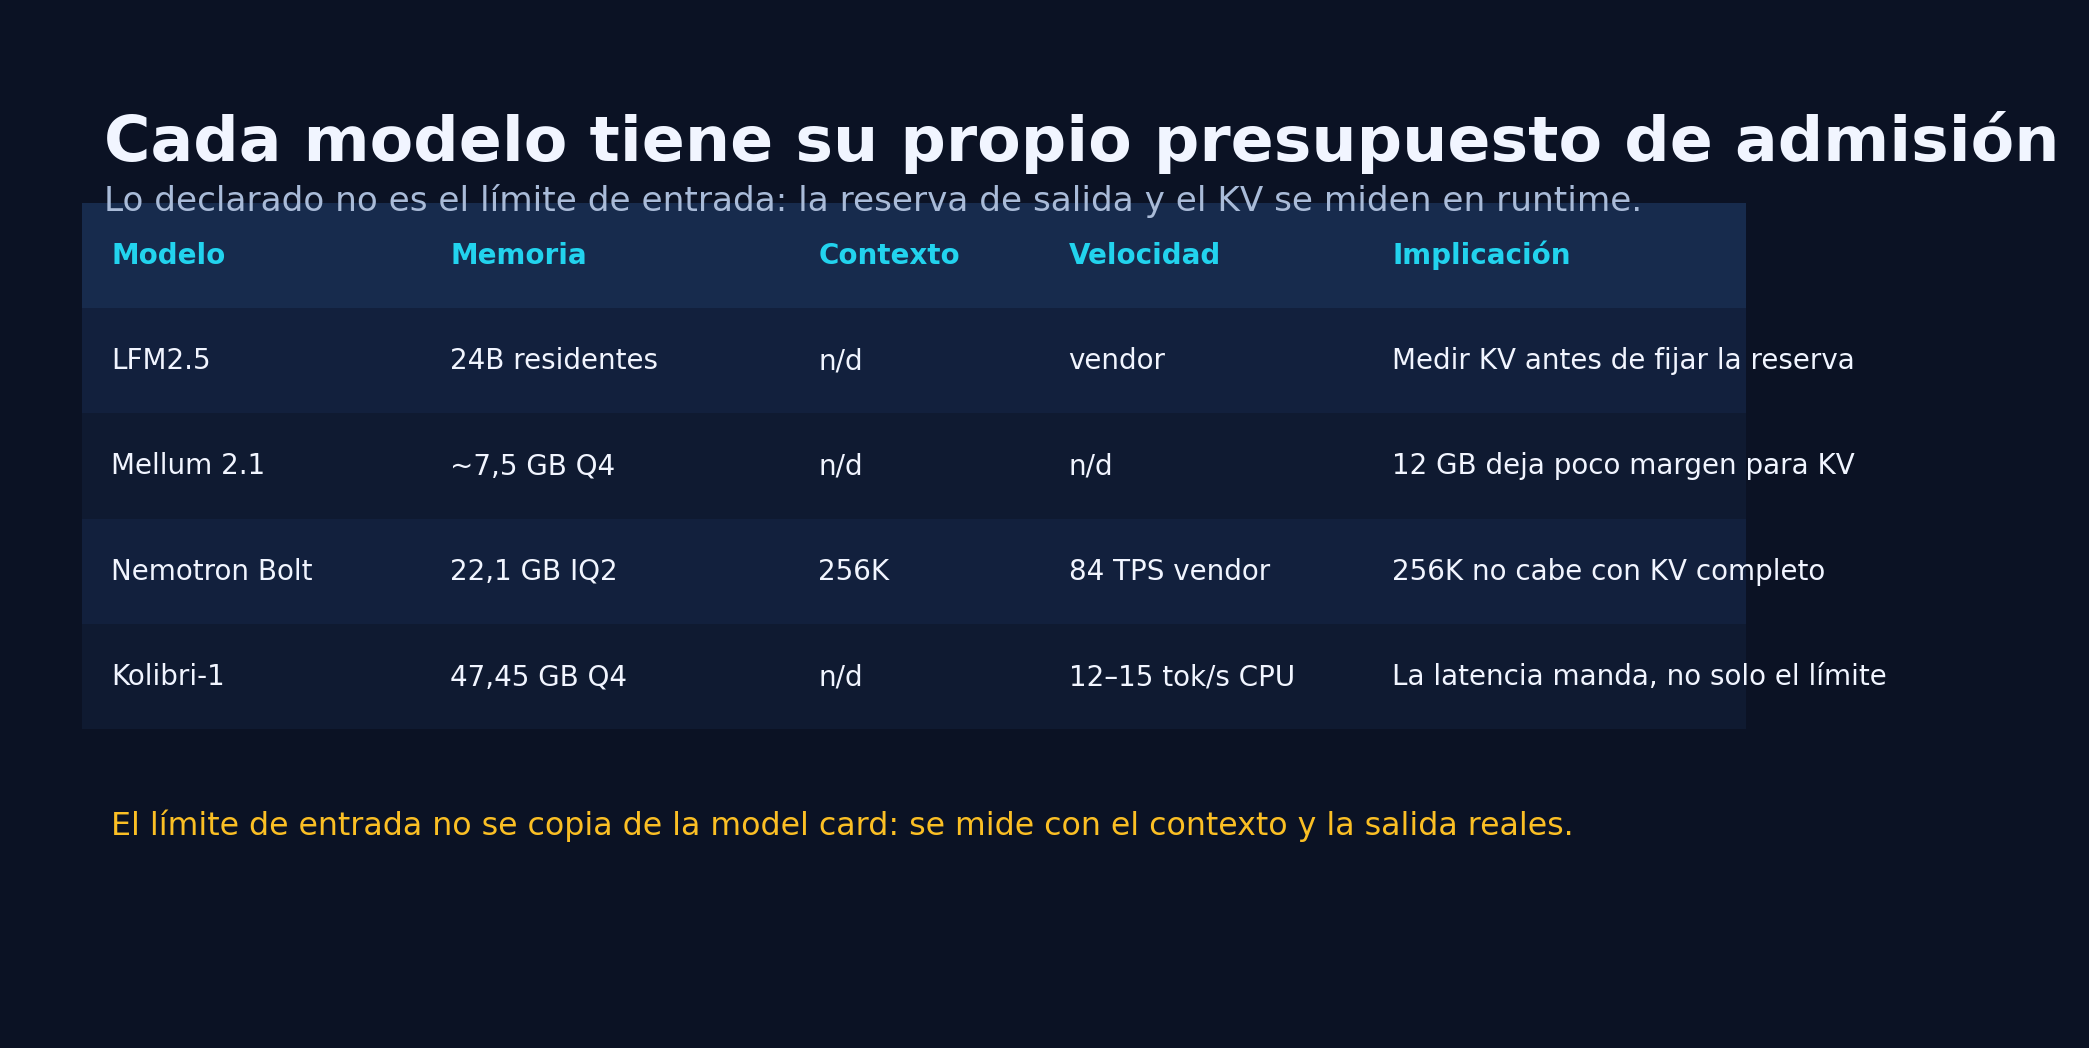
La tercera es de confianza. Los 84 TPS que reporta NVIDIA son del vendor y en su hardware de referencia. No hay un benchmark independiente al cierre de esta nota. Presentarlos como rendimiento doméstico sería un error.
Contexto y KV: el presupuesto real
El titular dice 256K de contexto. La pregunta es cuánto de eso cabe en 24 GB junto con los pesos. Los 22,1 GB ya dejan poco margen; el KV cache crece con cada token y cada capa. En la práctica, el contexto útil es menor que el máximo declarado, sobre todo si se usa visión o se mantiene una sesión larga.
La forma de saberlo es medir. Cargar el modelo, llenar el contexto hasta el límite y observar la memoria. Si el sistema empieza a hacer swapping, el contexto real es el que cabe antes del swap, no el que dice la model card. Esa medición es la que decide si el modelo sirve para un agente de sesión larga o solo para turnos cortos.
También hay un costo de velocidad. A más contexto, más memoria y más tiempo por token. El modelo puede ser rápido en un turno corto y lento en una conversación de 30.000 tokens. La latencia sostenida es la métrica que importa para un agente.
Para quién es y para quién no
Es para quien tiene una GPU de 24 GB o un DGX Spark y quiere un modelo grande con capacidades agénticas y visión. Es para quien puede aceptar una cuantización agresiva a cambio de tener un 74B en casa. Es para quien va a medir el contexto real y no se va a creer el titular de 256K.
No es para quien necesita precisión máxima en código o matemáticas. No es para quien tiene 16 GB. No es para quien espera que el modelo reemplace a un 4-bit de menor tamaño sin pérdida. La compresión es una apuesta; la apuesta puede salir bien o mal según la tarea.
Para seguir leyendo
El reporte técnico de Nemotron 3.5 Bolt tiene las tablas de compresión y las ablations; la model card detalla la licencia y los checkpoints. Si te interesa el marco del 2-bit, revisa el mapa de octubre; para el caso de 12 GB, Mellum 2.1; y para la frontera que no cabe, los modelos de 500B a 800B.
Preguntas frecuentes
¿Nemotron Bolt cabe en 24 GB con 256K de contexto?
Los pesos caben en 22,1 GB. El contexto completo de 256K no está verificado en 24 GB: el KV cache ocupa memoria adicional y reduce el contexto útil. Hay que medirlo.
¿La compresión a 2 bits es sin pérdida?
No. Es con pérdida por diseño. NVIDIA argumenta que un modelo más grande a 2 bits es un mejor compromiso que uno más pequeño a 4, pero la calidad depende de la tarea.
¿Los 84 TPS son reales en mi GPU?
Son del vendor y de su hardware de referencia. No hay benchmark independiente al cierre de esta nota; en una GPU de consumo el rendimiento puede ser distinto.
El conocimiento verdadero trasciende a lo público 🌀
Continúa explorando Inteligencia Artificial con piezas relacionadas y evidencia adicional.
Ver relacionados