
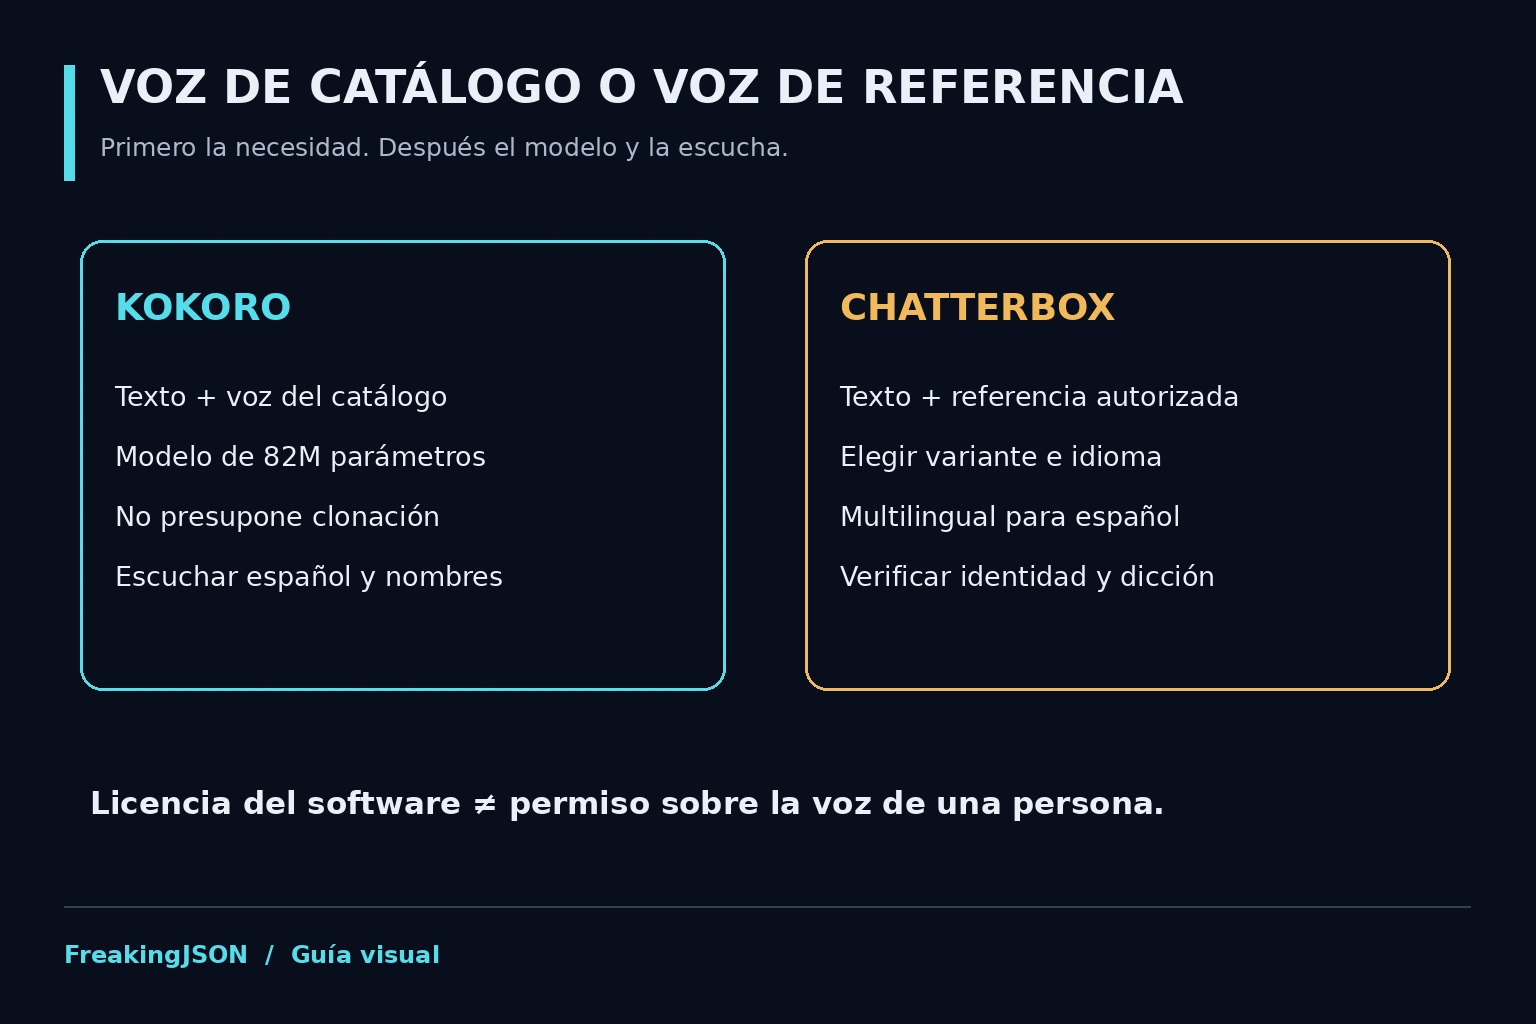
¿Necesitas una voz de catálogo para narrar o una voz basada en una referencia autorizada? Esa pregunta separa dos decisiones que los rankings suelen mezclar. Kokoro-82M ofrece una base ligera de texto a voz; Chatterbox es una familia con variantes diferentes. Para español, elegir la variante correcta importa tanto como elegir la familia.
En corto: elige por idioma y permiso de voz; decide la calidad escuchando.
Kokoro: empezar por una voz de catálogo
«Kokoro es un modelo de texto a voz de pesos abiertos con 82 millones de parámetros». — tarjeta oficial; traducción propia.
La tarjeta de Kokoro v1.0 publica pesos con licencia Apache 2.0 y un catálogo de voces. Su interfaz habitual recibe texto y una voz seleccionada. No presupongas un flujo de clonación a partir de la voz de un cliente: ese no es el mecanismo del catálogo estándar.
El tamaño reducido lo hace una opción a probar cuando el presupuesto de memoria importa. No garantiza una velocidad concreta en cualquier CPU. La puntuación, el idioma, la longitud del texto y las dependencias de conversión fonética también afectan el resultado.
Empieza con un párrafo que incluya las palabras de tu proyecto. Una voz convincente leyendo una demo inglesa puede pronunciar mal una marca o una fecha en español. Escucha antes de automatizar lotes.
Chatterbox no es un único modelo
La documentación oficial consultada distingue Turbo, Nano y Multilingual V3, además del modelo original y ajustes específicos por idioma. Turbo y Nano se presentan para inglés; Multilingual V3 se presenta como modelo general multilingüe. No tomes una cifra o una demostración de Turbo como garantía para narración española.
| Variante documentada | Tamaño publicado | Enfoque indicado por el autor |
|---|---|---|
| Chatterbox-Turbo | 350M parámetros | Inglés, menor latencia y etiquetas paralingüísticas |
| Chatterbox-Nano | 110M parámetros | Inglés y equipos con recursos limitados |
| Multilingual V3 | 500M parámetros | Cobertura multilingüe, incluido español |
Estas son descripciones del proveedor, no resultados comparativos de este artículo. Comprueba la versión instalada y la tarjeta de sus pesos. La documentación puede avanzar antes que tu entorno; actualizar un paquete no implica que hayas descargado o probado todas sus variantes.
Licencia del modelo y permiso de voz son cosas distintas
Apache 2.0 y MIT permiten usos amplios bajo sus condiciones, pero no te conceden automáticamente derechos sobre una voz, un guion, una interpretación o una marca. Conserva los avisos y condiciones aplicables y comprueba los derechos de los materiales que aportas.
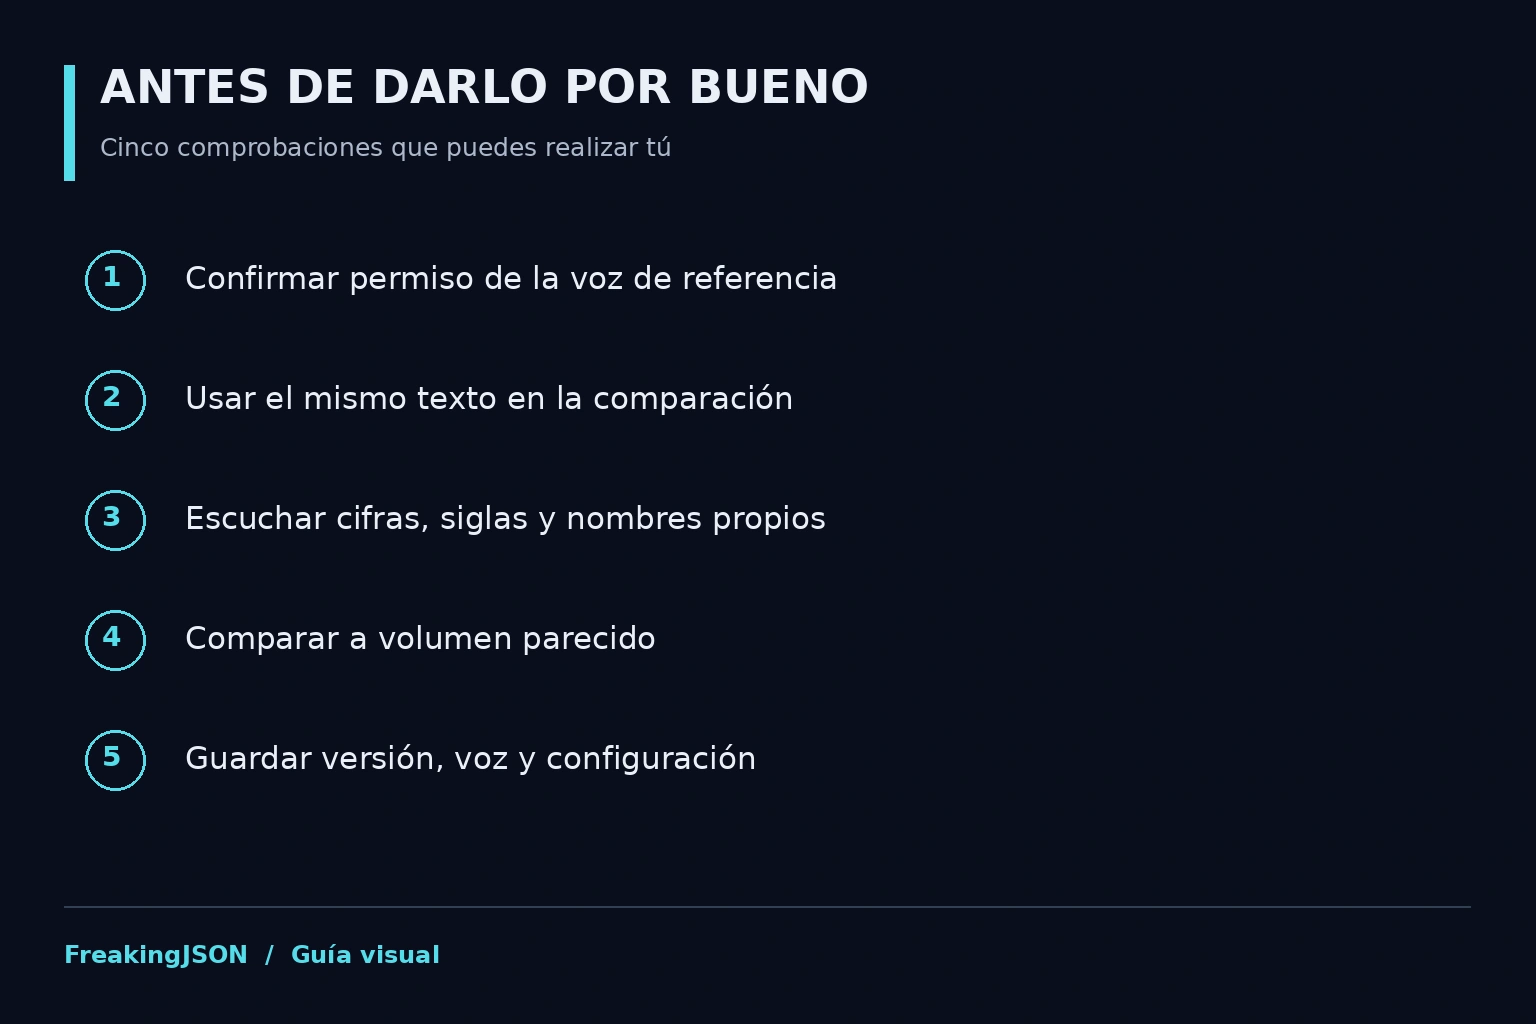
Para trabajar con una referencia vocal, usa tu propia voz o una muestra con permiso explícito para ese uso. Define dónde podrá difundirse, para qué finalidad y durante cuánto tiempo. No conviertas «me enviaron un audio» en «autorizaron una voz sintética». Si el resultado puede inducir a engaño, identifica su naturaleza sintética de forma clara.
Cómo hacer una comparación que tus oídos puedan decidir
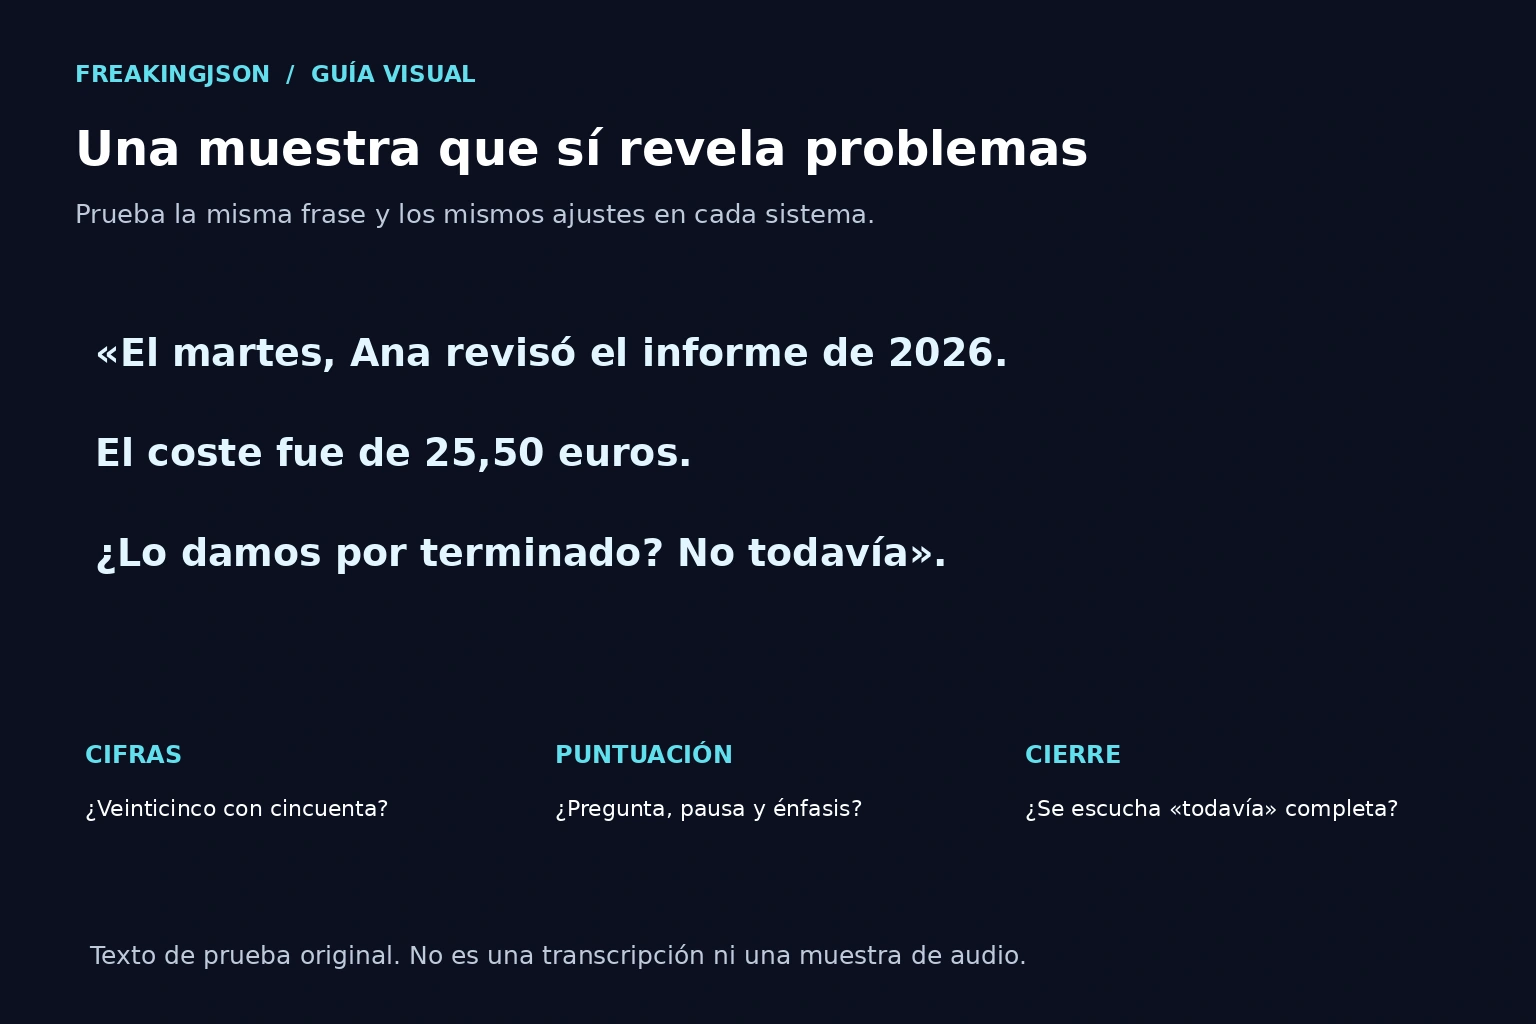
Usa el mismo texto: una frase neutra, una cifra, una sigla, un nombre propio y una oración con intención. Compara a volumen parecido; una muestra más fuerte suele parecer mejor. Escucha con audífonos y con el altavoz del teléfono, porque la mezcla final debe funcionar en ambos.
Evalúa pronunciación, estabilidad de timbre, pausas, omisiones y palabras inventadas. Una transcripción automática ayuda a localizar discrepancias, pero no califica emoción ni identidad de voz. Una diferencia textual puede ser un error de transcripción; vuelve siempre al audio antes de atribuirla al sintetizador.
Si necesitas tiempos, registra duración del audio y segundos de generación, separando carga inicial y ejecución caliente. No extrapoles una frase breve a un documental. Tampoco confundas tamaño del modelo con VRAM pico: el motor y la longitud de entrada importan.
Qué elegir para tu próximo proyecto
Narración con voz de catálogo: prueba Kokoro con tu idioma y texto. Si el resultado cumple, su sencillez puede ser una ventaja. Identidad vocal autorizada: evalúa una variante de Chatterbox que admita el idioma y el flujo de referencia que necesitas.
Contenido expresivo: no lo decidas solo con el parámetro de emoción. La dirección de voz incluye guion, ritmo, pausas y edición. Cambia un ajuste cada vez y conserva una muestra de comparación. En el Chatterbox original, el autor documenta exaggeration y cfg_weight; no asumas que todas las variantes ofrecen exactamente los mismos controles.
Evita prometer que diez segundos de referencia producirán una identidad perfecta o que una cifra fija de VRAM bastará siempre. La calidad de la muestra, el ruido, el idioma y la implementación afectan el resultado.
Regla de oro: el mejor TTS para tu pieza es el que puedes escuchar, corregir y usar con permiso; no el que gana una tabla ajena.
Dos recetas en español para empezar a escuchar
Usa entornos Python separados e instala las dependencias según cada repositorio; Kokoro en español requiere el soporte de eSpeak NG indicado por su documentación. La primera ejecución puede descargar pesos. Estos ejemplos son recetas de configuración, no pruebas de escucha ni mediciones de rendimiento.
Kokoro: voz de catálogo
from kokoro import KPipeline
import soundfile as sf

pipeline = KPipeline(lang_code="e", device="cpu")
texto = "Esta voz se genera en mi equipo. Escucha las pausas y la pronunciación."
for i, (_, _, audio) in enumerate(pipeline(texto, voice="ef_dora")):
    sf.write(f"kokoro-es-{i}.wav", audio, 24000)
El catálogo oficial usa lang_code="e" para español y enumera ef_dora, em_alex y em_santa. El ejemplo escribe cada segmento a 24 kHz: no sustituyas esa frecuencia por otra sin remuestrear.
Chatterbox Multilingual V3: síntesis en español
import torchaudio as ta
from chatterbox.mtl_tts import ChatterboxMultilingualTTS

model = ChatterboxMultilingualTTS.from_pretrained(device="cpu", t3_model="v3")
audio = model.generate(
    "Esta voz se genera en mi equipo. Escucha las pausas y la pronunciación.",
    language_id="es",
)
ta.save("chatterbox-es.wav", audio, model.sr)
La opción t3_model="v3" corresponde al ejemplo actual de Multilingual V3; confirma que tu versión la soporte. El código usa CPU para no exigir CUDA, no porque garantice tiempo real. Para referencias de voz, añade audio_prompt_path solo con un archivo propio o autorizado y siguiendo la interfaz del modelo elegido.
Descargas, dependencias y ejemplos: Kokoro, catálogo de voces y Chatterbox.
Preguntas frecuentes
¿Kokoro clona voces con un audio de referencia?
Su flujo estándar utiliza voces del catálogo; no debe presentarse como un sistema de clonación de referencia.
¿Chatterbox-Turbo es la opción automática para español?
No. La documentación lo orienta a inglés. Revisa Multilingual o los modelos de idioma adecuados.
¿MIT o Apache 2.0 permiten usar cualquier voz comercialmente?
No. Las condiciones del software no sustituyen los derechos de voz, guion o interpretación.
¿Una transcripción correcta prueba que la voz es natural?
No. Ayuda a revisar palabras, pero la naturalidad, intención y timbre requieren escucha.
Fuentes y siguientes lecturas
Documentación consultada el 14 de septiembre de 2026. Las capacidades corresponden a las versiones indicadas; comprueba la documentación de tu instalación.
El conocimiento verdadero trasciende a lo público 🌀
¿Quieres seguir la línea de investigación? Continúa con artículos relacionados y guarda esta lectura para volver después.
Ver relacionados