Un modelo pequeño puede adelantarse al grande sin tener la última palabra. Esa es la idea de la generación especulativa: proponer varios tokens y dejar que el modelo principal los verifique. La aceleración solo aparece si los pasos ahorrados compensan el coste de proponer y comprobar. No hay un multiplicador garantizado para tu equipo.
En corto: prueba la especulación solo con una configuración estable y compara respuestas completas.
La idea: adelantar trabajo, no saltarse la verificación
Un modelo autoregresivo produce una secuencia de tokens, unidades que pueden ser palabras, fragmentos o signos. Generarlos de uno en uno obliga a recorrer el modelo repetidamente. La generación especulativa intenta aprovechar una propuesta barata de varios tokens y validarla con el modelo que realmente quieres utilizar.
Piensa en un corrector con un ayudante: el ayudante adelanta una frase y el corrector acepta el tramo válido. En el primer desacuerdo, corrige y continúa. No se entrega sin revisar todo lo que escribió el ayudante. La analogía explica el flujo, no el algoritmo probabilístico completo.
MTP, borrador auxiliar y n-gramas no son lo mismo
Speculative decoding es la familia de técnicas. Un borrador auxiliar puede ser otro modelo más pequeño. MTP, predicción de múltiples tokens, puede proporcionar propuestas mediante componentes específicos del modelo; requiere soporte tanto del checkpoint como del motor. Los métodos basados en n-gramas aprovechan secuencias presentes en el contexto o una caché.
| Método | De dónde sale la propuesta | Qué comprobar |
|---|---|---|
| Borrador auxiliar | Otro modelo compatible | Memoria adicional, tokenizer y aceptación |
| MTP | Componentes de predicción específicos | Que modelo y motor implementen esa modalidad |
| N-gramas | Patrones de tokens previos | Repetición útil en tu carga y coste de búsqueda |
La documentación actual de llama.cpp distingue expresamente draft-simple, draft-mtp y varias opciones ngram-*. Que aparezca una opción en la ayuda no demuestra que funcione con cualquier archivo GGUF. Tampoco debes sumar porcentajes de métodos distintos: sus costes e interacciones se miden juntos.
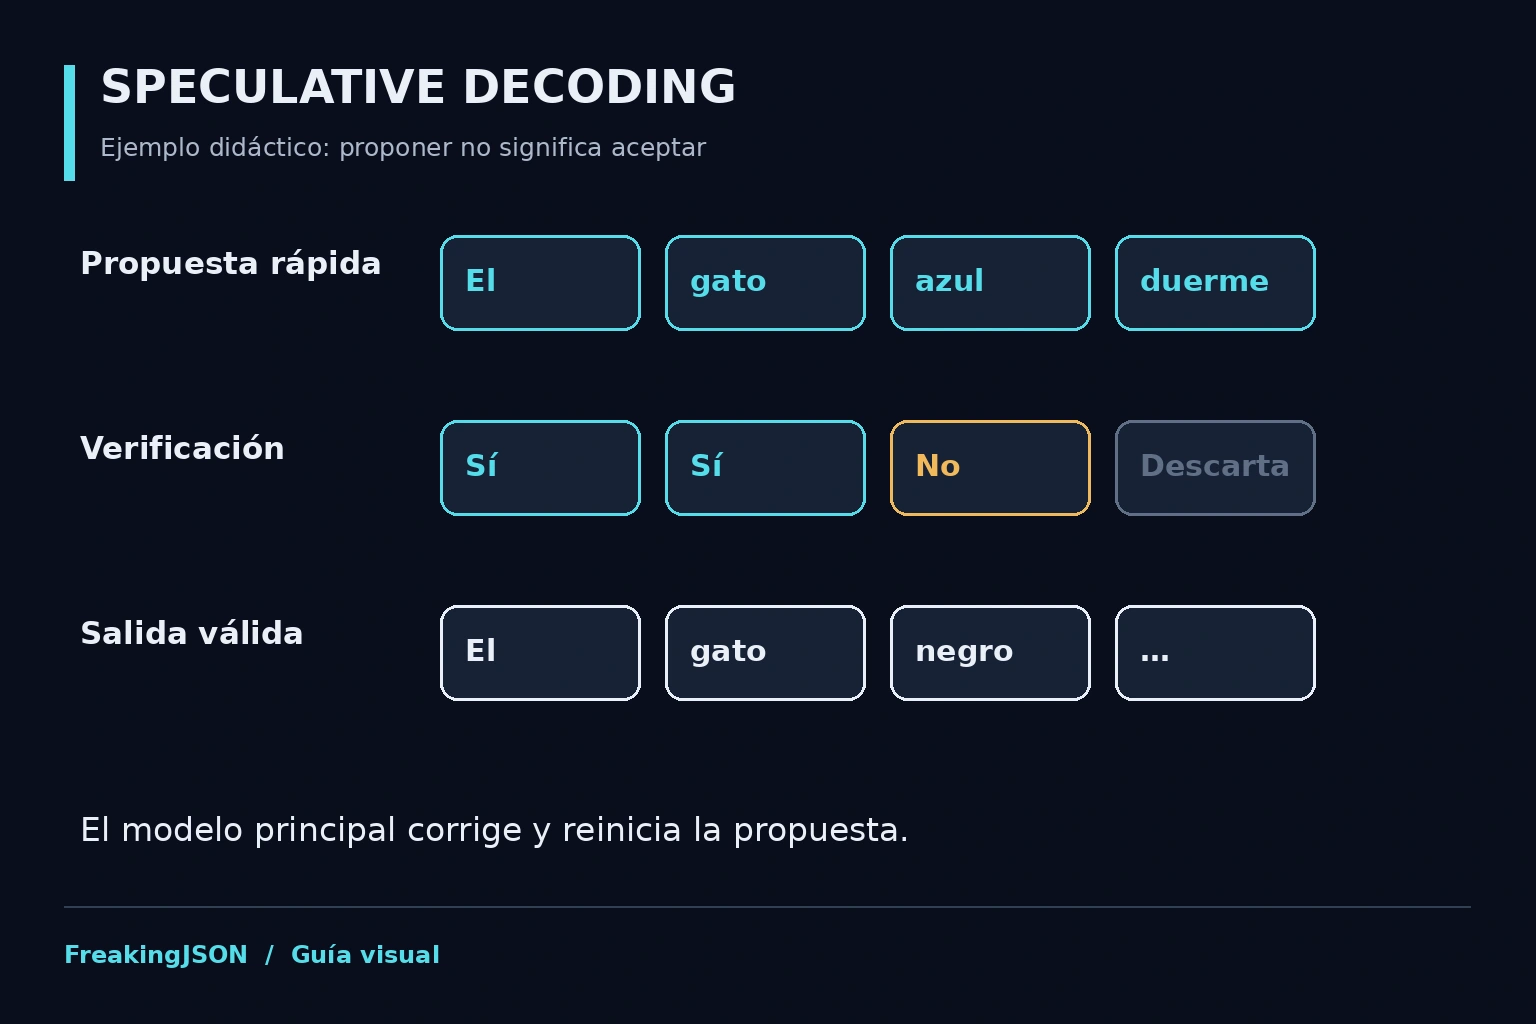
Mira dónde se acepta y dónde se corrige
La palabra «azul» del ejemplo es rechazada; el resto del borrador ya no puede aceptarse como si nada hubiese cambiado. En una implementación probabilística, la regla de aceptación es más precisa que comparar palabras. Las garantías del método dependen de aplicar correctamente esa regla, no solo de añadir un segundo modelo.
Qué medir para no confundir rapidez con utilidad
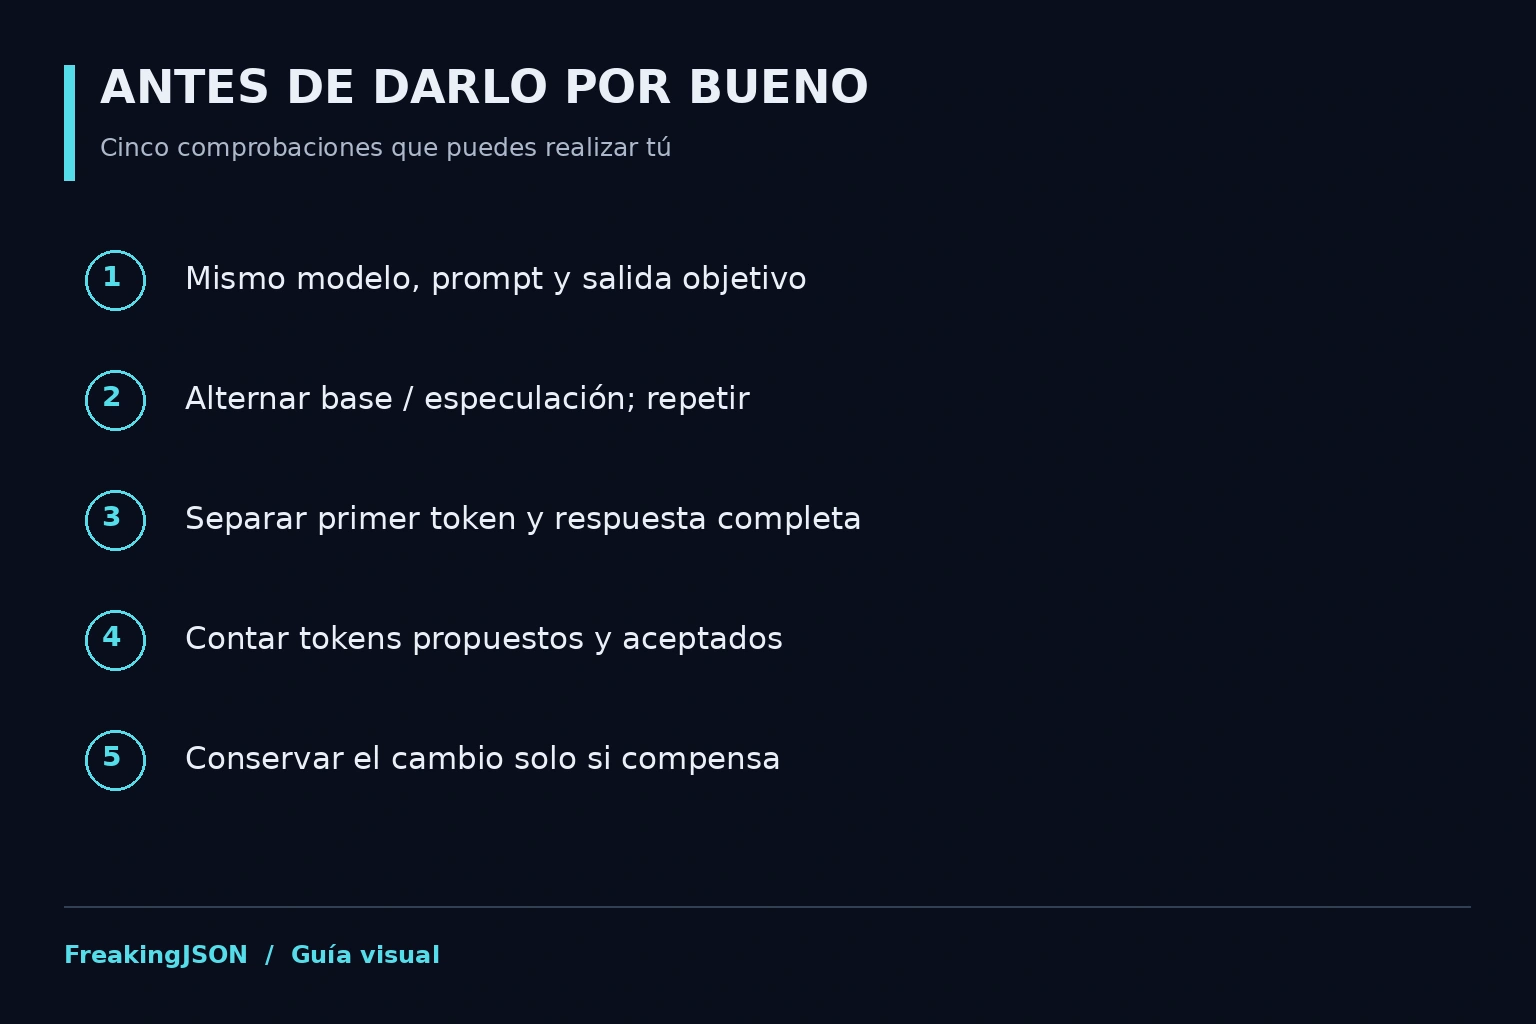
Separa el tiempo hasta el primer token del tiempo hasta una respuesta completa. Un cambio puede ayudar a generar una respuesta larga y apenas notarse en una respuesta de dos líneas. Mide también tokens propuestos, aceptados y memoria máxima. La aceptación alta ayuda, pero no basta si producir el borrador es caro.
Prepara un conjunto pequeño de tareas representativas y alterna ejecuciones con y sin especulación. Conserva el mismo modelo principal, cuantización, versión del motor, contexto y parámetros de muestreo. Haz varias repeticiones: una ejecución con el equipo frío frente a otra con modelos en caché no aísla la técnica.
Revisa el resultado final con el mismo criterio en ambos casos. Para código, ejecuta las pruebas; para extracción, contrasta campos con el documento. El rendimiento útil no consiste en generar más texto incorrecto por segundo.
Cuándo merece una prueba y cuándo conviene esperar
Es una candidata razonable si generas respuestas largas, dispones de memoria y el motor soporta una combinación documentada. Los n-gramas merecen atención cuando hay repetición aprovechable, por ejemplo edición de código cercano al contexto. Son hipótesis de trabajo, no una promesa de mejora.
Espera si todavía no tienes una configuración estable, si el modelo ya necesita descargar capas a RAM por falta de espacio o si cada intento cambia también el contexto y el muestreo. Primero consigue una respuesta correcta y repetible; luego optimiza una sola variable.
«Demostración de técnicas de decodificación especulativa y decodificación especulativa basada en árboles». — llama.cpp, descripción del ejemplo; traducción propia.
Regla de cierre: no conserves una opción por su nombre. Consérvala si mejora tu tarea sin introducir un coste mayor en memoria, complejidad o errores.
Receta: comparar una base y una sola técnica
Antes de empezar: instala llama.cpp, comprueba que llama-server esté en tu PATH y sustituye la ruta de ejemplo por un GGUF compatible que quepa en tu memoria. Usa un puerto libre. La siguiente receta documenta la configuración; no promete una aceleración medida.
1. Arranque sin especulación
llama-server --model "/ruta/a/tu-modelo.gguf" \
  --ctx-size 4096 --parallel 1 --n-predict 512 \
  --host 127.0.0.1 --port 8087 --spec-type none
Guarda varias respuestas a la misma tarea y su tiempo total. Detén ese servidor antes de la siguiente ejecución: no cargues ambos a la vez.
2. Prueba n-gramas sin un segundo modelo
llama-server --model "/ruta/a/tu-modelo.gguf" \
  --ctx-size 4096 --parallel 1 --n-predict 512 \
  --host 127.0.0.1 --port 8087 --spec-type ngram-simple
Solo cambia --spec-type. Los n-gramas aprovechan repeticiones; no convierten un modelo en MTP y pueden no mejorar tu tarea.
3. MTP es una receta distinta
Úsala únicamente si tu versión enumera draft-mtp en la ayuda y la documentación confirma la compatibilidad del modelo. En ese caso, el bloque documentado de opciones es:
--spec-type draft-mtp --spec-draft-n-max 2 --spec-draft-n-min 1Ese bloque no es un comando completo. Debe añadirse a una configuración compatible; no basta con que el archivo termine en GGUF. La ayuda de cada versión manda: no copies alias retirados de tutoriales antiguos.
Consulta las opciones del servidor y los ejemplos de decodificación especulativa.
Preguntas frecuentes
¿MTP siempre acelera?
No. Depende del soporte del modelo y del motor, de la aceptación y del coste de generar y verificar las propuestas.
¿Necesito cargar dos modelos?
Algunos métodos usan un borrador auxiliar. Otros emplean componentes MTP o patrones de n-gramas; no comparten todos los requisitos.
¿Es correcto comparar solo tokens por segundo?
No. Registra también tiempo de respuesta completa, primer token, memoria y corrección de la salida.
¿Puedo activar draft-mtp en cualquier GGUF?
No. La presencia de la opción no prueba compatibilidad con el archivo. Consulta el soporte concreto del motor y del modelo.
Fuentes y siguientes lecturas
Documentación consultada el 14 de septiembre de 2026. Las capacidades corresponden a las versiones indicadas; comprueba la documentación de tu instalación.
- llama.cpp: ejemplo de generación especulativa
- llama.cpp: opciones actuales del servidor
- Leviathan, Kalman y Matias: Fast Inference from Transformers via Speculative Decoding
- Transformers: estrategias de generación
- IA local sin humo: elegir a partir de pruebas
- Prefill, razonamiento y decode: no confundas las métricas
- Modelos, interfaces y agentes: qué estás eligiendo
- Qué comprobar en un modelo para programar
El conocimiento verdadero trasciende a lo público 🌀
¿Quieres seguir la línea de investigación? Continúa con artículos relacionados y guarda esta lectura para volver después.
Ver relacionados