Escribes una idea, generas una imagen, la animas y añades voz. Parece una sola tarea, pero terminar un video requiere coordinar etapas y revisar cada transición. Este ejemplo local separa imagen, movimiento, audio y montaje para que puedas repetir una parte sin rehacerlo todo. El hardware y la configuración de cada modelo condicionan el resultado.
El resultado: un Reel real de 45 segundos
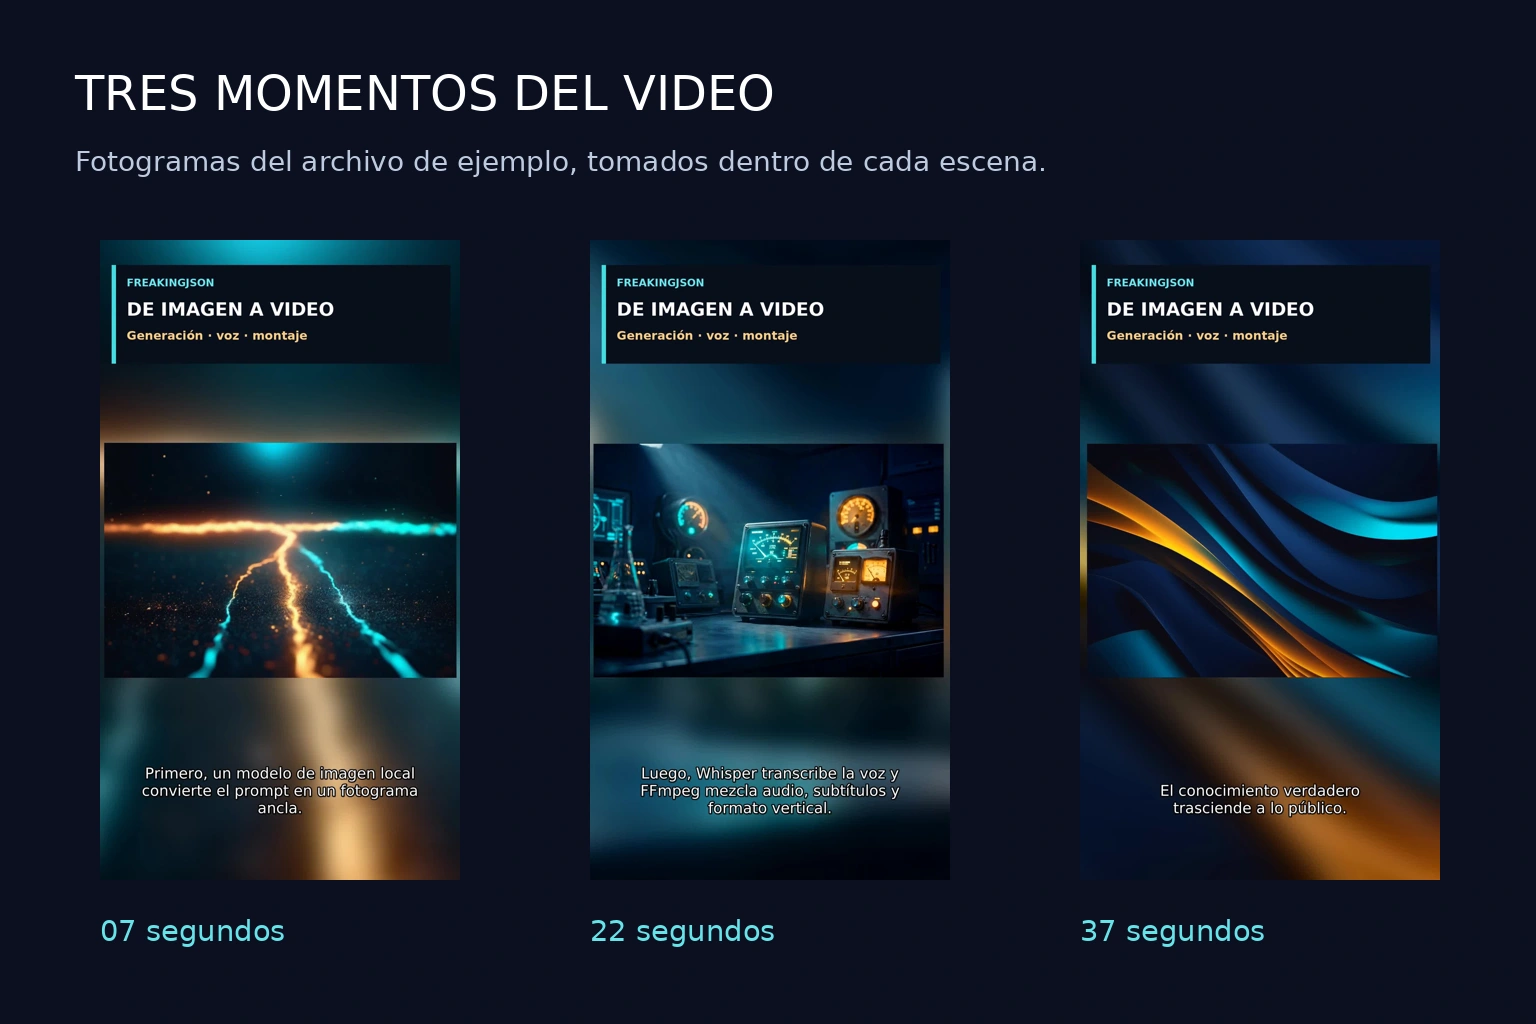
El video combina imágenes generadas localmente, un clip de movimiento de LTX 2.3, voz española, música programada y subtítulos integrados. Es una muestra de montaje: no todo movimiento visible procede del modelo de video, y el clip LTX no demuestra que la misma imagen ancla se conserve durante toda la secuencia.
El archivo de ejemplo está codificado en H.264 a 1080×1920 y 24 fotogramas por segundo, con audio AAC a 48 kHz. Sirve para observar el montaje, no para prometer que cualquier GPU pueda generarlo a la misma velocidad. Si comienzas, revisa tu primera media hora con IA.
El pipeline completo, paso a paso
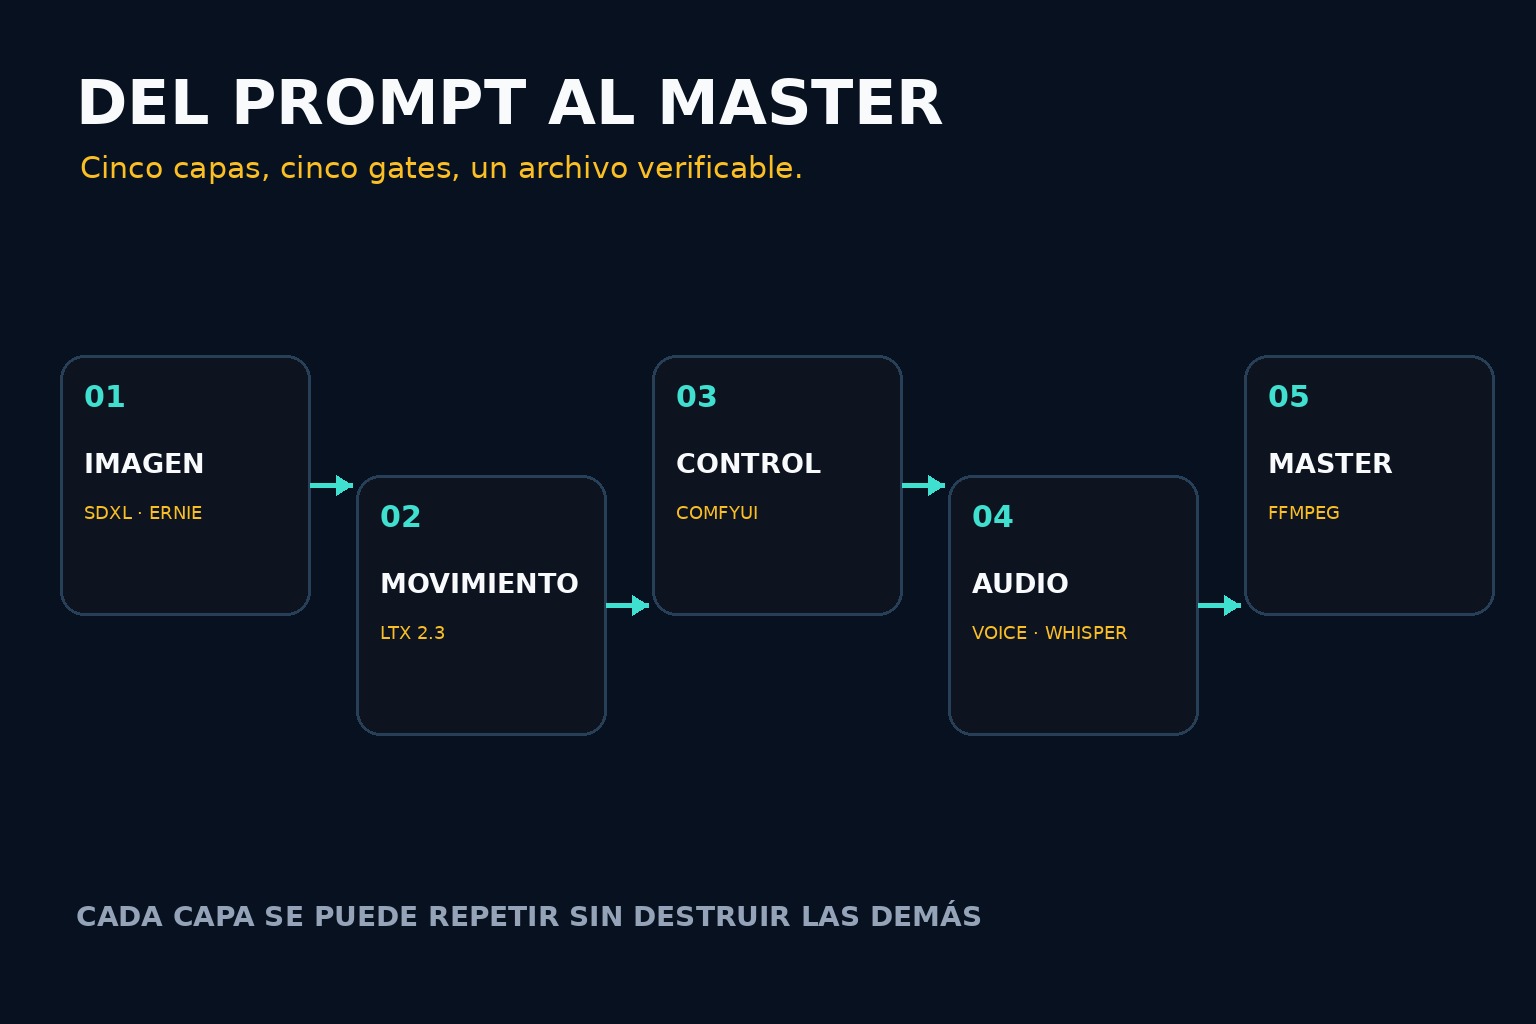
El error más común es pedirle a una sola herramienta que resuelva todo. En producción local conviene dividir responsabilidades. Un modelo de imagen fija crea composición y estilo. Un modelo de video interpreta el movimiento. ComfyUI conserva la receta. Whisper transforma voz en texto. FFmpeg reúne capas, normaliza audio y entrega el master. Cada herramienta hace menos, pero el sistema completo hace más.
| Etapa | Herramienta | Entrada | Salida | Gate |
|---|---|---|---|---|
| Imagen | SDXL o ERNIE-Image | Prompt + dirección visual | Anchor 1536×1024 | Composición y derechos |
| Movimiento | LTX 2.3 | Anchor + prompt de acción | Clip H.264 | Flicker, geometría, continuidad |
| Orquestación | ComfyUI | Workflow versionado | Run reproducible | Manifest + seed + hashes |
| Audio | OmniVoice + Whisper | Guion aprobado | VO + SRT | Dicción, timing, LUFS |
| Montaje | FFmpeg | Video + VO + música + SRT | MP4 vertical | Decode, safe-view, true peak |
Esta separación también facilita cambiar una pieza sin reiniciar todo. Si la voz falla, regeneras audio; si una toma de LTX se deforma, cambias ese beat. Es la misma filosofía que usamos al elegir modelos y agentes según el trabajo y al montar workflows locales de ComfyUI.
1. Crear la imagen ancla
La imagen ancla define personaje, iluminación, paleta y composición. Para una pieza vertical, no basta con generar algo bonito en horizontal y recortarlo después. Hay que reservar aire para subtítulos, mantener la acción lejos de bordes y pensar dónde caerá la interfaz de Instagram o TikTok.
Las imágenes de este ejemplo proceden de SDXL y ERNIE-Image. Antes de animar, comprueba composición, identidad y espacio para subtítulos. Elegir un modelo distinto no corrige automáticamente un mal encuadre. Para compararlos, revisa qué cambia entre ERNIE y SDXL.
2. Pasar de imagen a movimiento con LTX 2.3
LTX interpreta la imagen y propone una secuencia temporal. Aquí aparecen los problemas que una miniatura oculta: flicker, manos que cambian, objetos que se derriten o encuadres que se desplazan. Por eso revisamos un contact sheet y el video completo. Una sola captura bonita no certifica cinco segundos de movimiento.
Generar un clip puede tardar mucho más que reproducirlo. Si una configuración agota el tiempo o la memoria, reduce una variable y vuelve a probar: resolución, longitud y pasos no son equivalentes. Conserva una toma válida y su receta antes de ampliar el proyecto; no presupongas que una ejecución pasada garantiza la siguiente.
Un clip válido se adapta al formato vertical sin deformarlo. En este ejemplo se conserva el centro de la imagen y se amplía el fondo; los títulos quedan dentro de una zona segura. Esto evita estirar personas u objetos. Revisa el encuadre también en un teléfono antes de exportar. Sigue con el flujo de edición con IA local.
3. Voz, música y subtítulos
El audio determina si la pieza se siente como un experimento o como contenido editorial. Generamos la voz en español con OmniVoice local y luego ejecutamos Whisper sobre el WAV. La transcripción detectó correctamente la estructura, pero confundió nombres técnicos como LTX, ComfyUI y FFmpeg. Conservamos los timings y corregimos únicamente esos términos contra el guion fuente.
La música programada con Strudel acompaña a la voz a un nivel menor y reduce su volumen cuando entra la narración. Este ajuste se conoce como ducking. Escucha la pieza completa: un medidor no detecta por sí solo una voz monótona, una palabra mal pronunciada o una pausa incómoda.
4. Comprobaciones antes de exportar
Que FFmpeg termine sin error no significa que el video sea correcto. Comprueba que los subtítulos no estén recortados, que los caracteres especiales se representen bien y que las transiciones no dejen fotogramas negros. Reproduce el archivo de principio a fin después de exportar, no solo dentro del editor.
- Reproducción: abrir y decodificar el archivo completo, no solo su portada.
- Continuidad: revisar parpadeos, deformaciones y saltos entre tomas.
- Texto: comprobar subtítulos y títulos en un teléfono.
- Audio: escuchar principio y final de cada frase y el balance con música.
Estas pruebas no reemplazan criterio humano. Sirven para eliminar errores objetivos antes de pedir atención a una persona. Es la misma disciplina que aplicamos al interpretar benchmarks de IA sin confundir una cifra con una experiencia completa y al instalar un agente local con una ruta verificable.
Modelos, herramientas y fuentes oficiales
- LTX-2 oficial y model card de LTX-2.3.
- nodos oficiales ComfyUI-LTXVideo.
- ComfyUI y su documentación oficial.
- Whisper de OpenAI.
- documentación oficial de FFmpeg.
- SDXL Base 1.0 y ERNIE-Image.
Las fuentes oficiales documentan cada herramienta; no garantizan el rendimiento de una configuración particular. Comprueba requisitos y licencias del modelo exacto antes de descargarlo.
«Whisper es un modelo de reconocimiento de voz de propósito general». — documentación de OpenAI; traducción propia.
Preguntas frecuentes
¿Se puede crear un video completo sin nube?
Sí, si cuentas con modelos y herramientas locales para imagen, movimiento, voz, transcripción y montaje. La velocidad dependerá del hardware y de la receta.
¿Cuánta VRAM necesitas?
Este experimento se ensambló alrededor de una RTX 5060 Ti de 16 GB. Eso demuestra nuestro entorno, no un mínimo universal. Revisa cada model card antes de descargar.
¿Por qué usar una imagen ancla?
Porque fija identidad, composición y paleta antes de introducir movimiento. Reduce variables y facilita repetir solo el beat que falla.
¿Whisper genera la voz?
No. Whisper transcribe audio. En este pipeline la voz se generó por otra lane local y Whisper creó timings para subtítulos y readback.
¿El Reel ya está listo para publicar?
Este archivo es una muestra del proceso. Una pieza destinada a publicación necesita comprobar derechos, dicción, ritmo y legibilidad en el dispositivo donde se verá.
El conocimiento verdadero trasciende a lo público 🌀
¿Quieres seguir la línea de investigación? Continúa con artículos relacionados y guarda esta lectura para volver después.
Ver relacionados


