
En este artículo

La noticia se lee como una promesa: “open weights de 800B”. La letra pequeña es otra: para ejecutar ese checkpoint hacen falta cientos de gigabytes de memoria, varias GPUs de datacenter o un clúster de mini-PCs. La apertura del modelo no reduce su tamaño. Solo cambia quién puede descargarlo.
La semana de los 800B
En cuatro días salieron tres modelos que comparten una etiqueta y casi nada más. Muse Spark Open: 816B parámetros totales, 42B activos, 1M de contexto y licencia Muse. Reflection Beam: 501B totales, 23B activos, 1M de contexto y Apache 2.0. Step 5 Preview: 600B totales, 27B activos y licencia StepFun.
Los tres son “open weights”: los pesos se pueden descargar. Eso no significa que sean “open source” en el sentido de la OSI, ni que su licencia permita cualquier uso, ni que se puedan ejecutar en una GPU de consumo. La confusión entre esas tres cosas es la base de casi todos los titulares de la semana.
“Open weights significa que puedes descargar el checkpoint, no que puedas ejecutarlo.” — Principio editorial.

Qué significa open weights
Open weights significa que el checkpoint está disponible para descargar. No significa que el código de entrenamiento esté disponible, ni que los datos sean abiertos, ni que la licencia permita uso comercial sin condiciones. Cada modelo tiene su propio régimen: Muse tiene una licencia propia; Beam usa Apache 2.0; Step 5 usa la licencia de StepFun.
La distinción importa porque “open” se usa como sinónimo de “libre” y de “local”. Ninguna de las dos equivalencias se sostiene. Un modelo puede ser open weights y no ser local por tamaño. Puede ser local y no ser libre por licencia. Puede ser libre y no ser práctico por latencia.
Los tres modelos y sus pisos
Los números de memoria son la parte incómoda. Beam tiene un checkpoint NVFP4 de aproximadamente 280 GB; su versión BF16 pasa de 1 TB. La guía de despliegue recomienda cuatro B200. Step 5, en un quant comunitario Q2, ronda los 217 GB y se midió en cuatro DGX Spark. Muse Spark, con 816B y NVFP4, tiene un piso teórico de más de 200 GB antes de contar contexto y overhead.
| Modelo | Parámetros | Activos | Licencia | Piso estimado |
|---|---|---|---|---|
| Muse Spark Open | 816B | 42B | Muse | ~200 GB en 2-bit + overhead |
| Reflection Beam | 501B | 23B | Apache 2.0 | ~280 GB NVFP4 |
| Step 5 Preview | 600B | 27B | StepFun | ~217 GB Q2 |
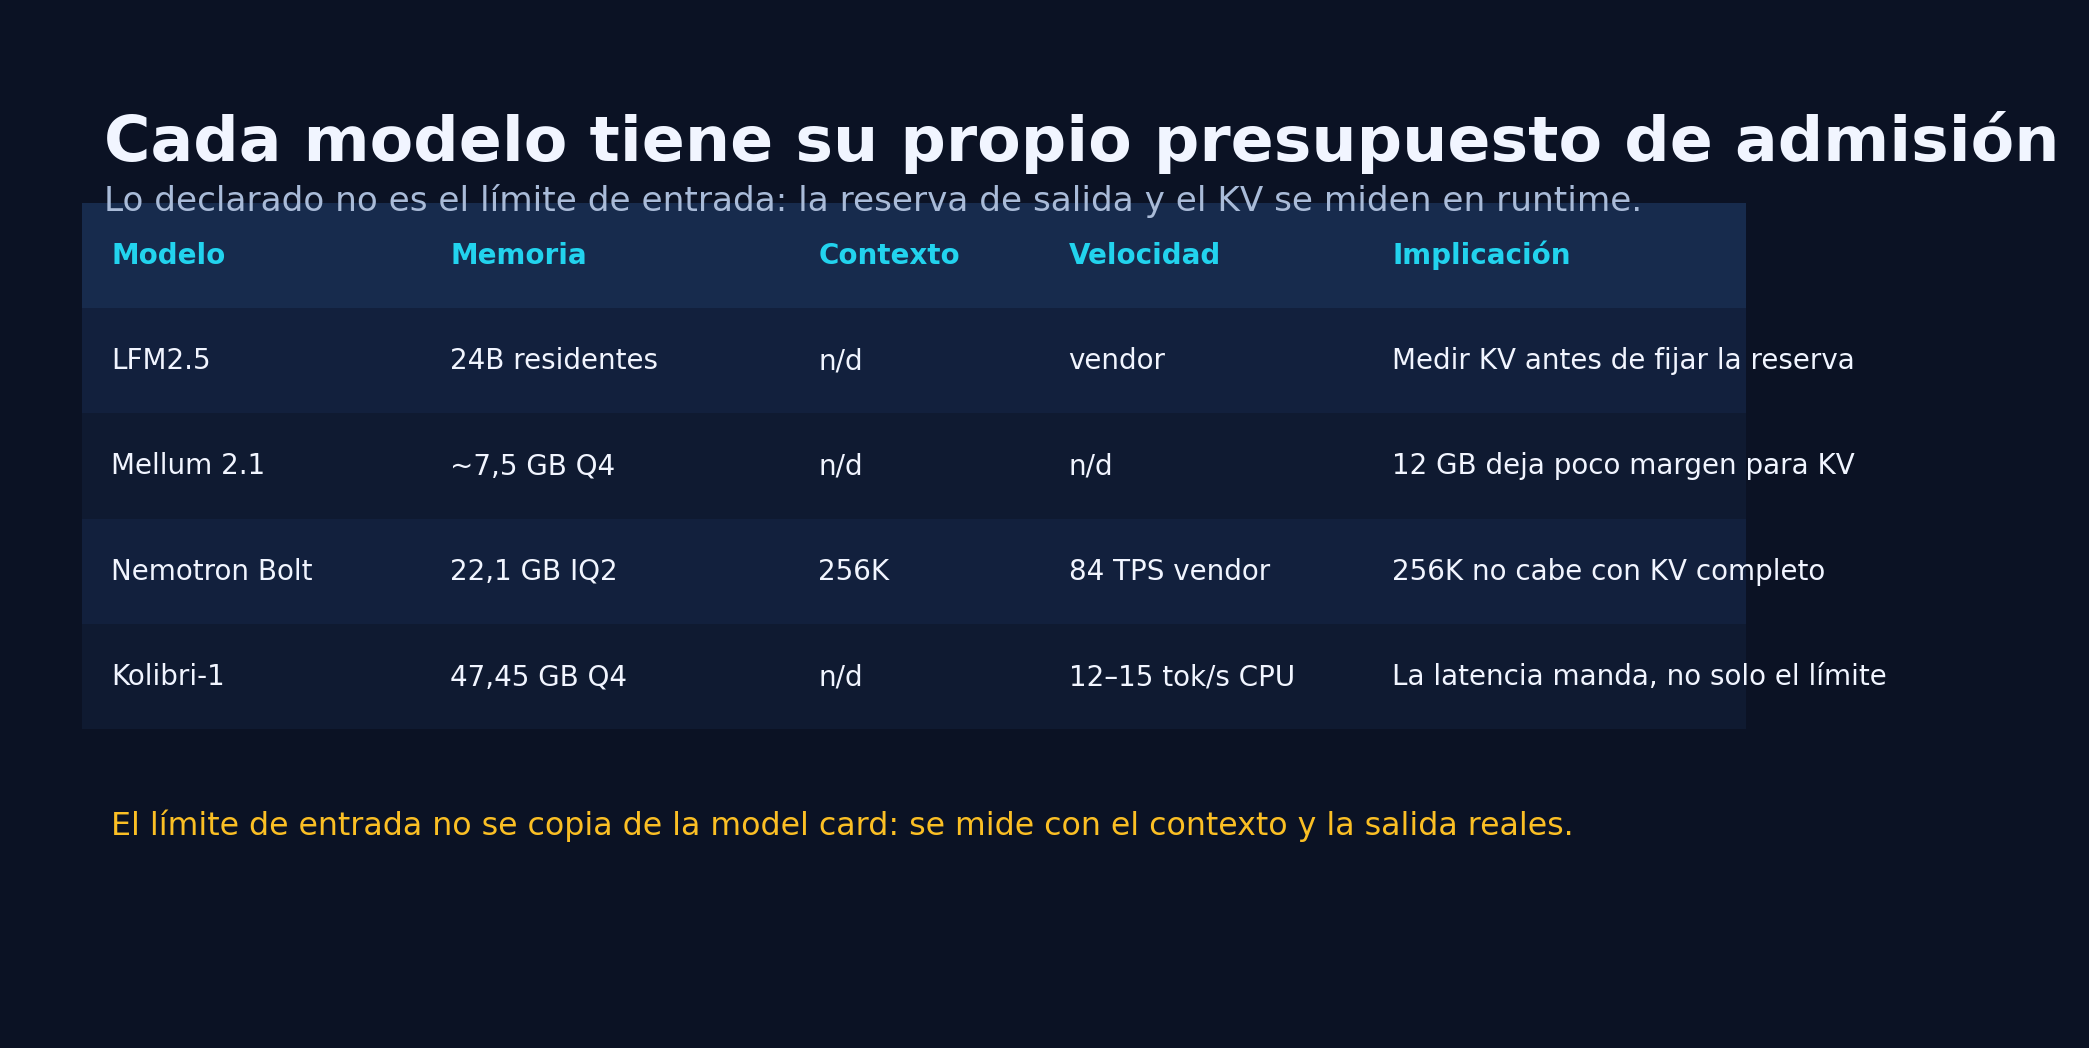
Los pisos son estimaciones de terceros y varían con el contexto, el runtime y el tipo de KV cache. No son cifras universales. Lo que sí es universal es la conclusión: ninguno cabe en 16, 24 o 48 GB. La diferencia entre un modelo de consumo y estos checkpoints es de un orden de magnitud, no de un ajuste de quant.
La distancia no se cierra con un quant más agresivo. Bajar de 4 a 2 bits reduce el peso, pero también la calidad y el margen para contexto. Un checkpoint de 200 GB a 2 bits sigue necesitando 200 GB de memoria; el problema es físico, no de formato. La única forma de cerrar la brecha es cambiar de hardware o cambiar de modelo.
Por qué 2 bits no alcanza
La intuición dice que si 16 bits no caben, 2 bits deberían caber. La aritmética dice otra cosa. Un modelo de 816B a 2 bits ocupa, en teoría, unos 204 GB solo en pesos. A eso hay que sumar el contexto, la caché KV, los buffers de inferencia y el overhead del runtime. En la práctica, el piso sube, no baja.
El segundo problema es el ancho de banda. Mover cientos de gigabytes por token es caro incluso si el modelo cabe. La velocidad no depende solo de los parámetros activos: depende de cuántos pesos hay que leer para cada token. Un MoE de 42B activos sigue necesitando acceso a los expertos que el router selecciona, y esos expertos viven en memoria.
El tercer problema es la calidad. La cuantización agresiva es una decisión de Pareto: se acepta pérdida para ganar tamaño. En un modelo de frontera, esa pérdida puede ser aceptable para algunas tareas y catastrófica para otras. No es un interruptor; es un trade-off que se mide.
Quién puede correrlos
Pueden correrlos quienes tienen un clúster: cuatro B200, cuatro DGX Spark o infraestructura equivalente. También quienes alquilan capacidad por API. No pueden correrlos quienes tienen una RTX de 16 o 24 GB, por mucho que el checkpoint sea “open”. La barrera es física, no legal.
Eso no invalida la apertura. Un modelo abierto de frontera sigue siendo útil para investigación, para fine-tuning en datacenter y para construir productos sobre una API. Lo que invalida es la promesa de “IA local” asociada al titular. La apertura democrátiza el acceso al código, no el acceso al hardware.
Qué sí puede hacer un usuario
Si tu hardware es de consumo, la ruta realista es otra. Usar estos modelos vía API cuando la tarea lo justifique. Elegir modelos abiertos de 8B a 30B para el trabajo local. Medir el piso de memoria con el contexto real, no con el mínimo. Y aceptar que “local” y “frontera” son categorías que rara vez se cruzan.
La comparación útil no es “¿puedo correr el modelo más grande?”. Es “¿qué modelo me da la mejor relación entre calidad, latencia y costo para mi tarea?”. Para muchas tareas, un modelo de 12B a 24B bien elegido es suficiente. Para otras, la API de un modelo de frontera es la única opción sensata.
Para seguir leyendo
El blog de Reflection Beam detalla el checkpoint NVFP4 y la recomendación de cuatro B200; el blog de vLLM sobre Muse Spark cubre la arquitectura 816B-A42B. El rundown de modelos abiertos para home lab pone los pisos en contexto. Si te interesa el 2-bit, revisa el mapa de octubre; para el caso de 12 GB, Mellum 2.1; y para el contexto, checkpoint y compactación.
Preguntas frecuentes
¿Open weights es lo mismo que open source?
No. Open weights significa que los pesos se pueden descargar; open source implica que el código y los datos de entrenamiento también están disponibles con una licencia que permite modificarlos y redistribuirlos.
¿Puedo correr Beam en una RTX 4090?
No. Su checkpoint NVFP4 ronda los 280 GB y la guía recomienda cuatro B200. La barrera es de memoria, no de licencia.
¿2 bits permite correr un modelo de 800B en 24 GB?
No. A 2 bits, 816B ocupan unos 204 GB solo en pesos, antes de contexto, KV y overhead. El quant no cambia el orden de magnitud.
El conocimiento verdadero trasciende a lo público 🌀
Continúa explorando Inteligencia Artificial con piezas relacionadas y evidencia adicional.
Ver relacionados